哈希冲突与扩容
哈希冲突与扩容
跳转到“哈希冲突与扩容”从本质上看,哈希函数的作用是将所有 key 构成的输入空间映射到数组所有索引构成的输出空间,而输入空间往往远大于输出空间。因此,理论上一定存在“多个输入对应相同输出”的情况。
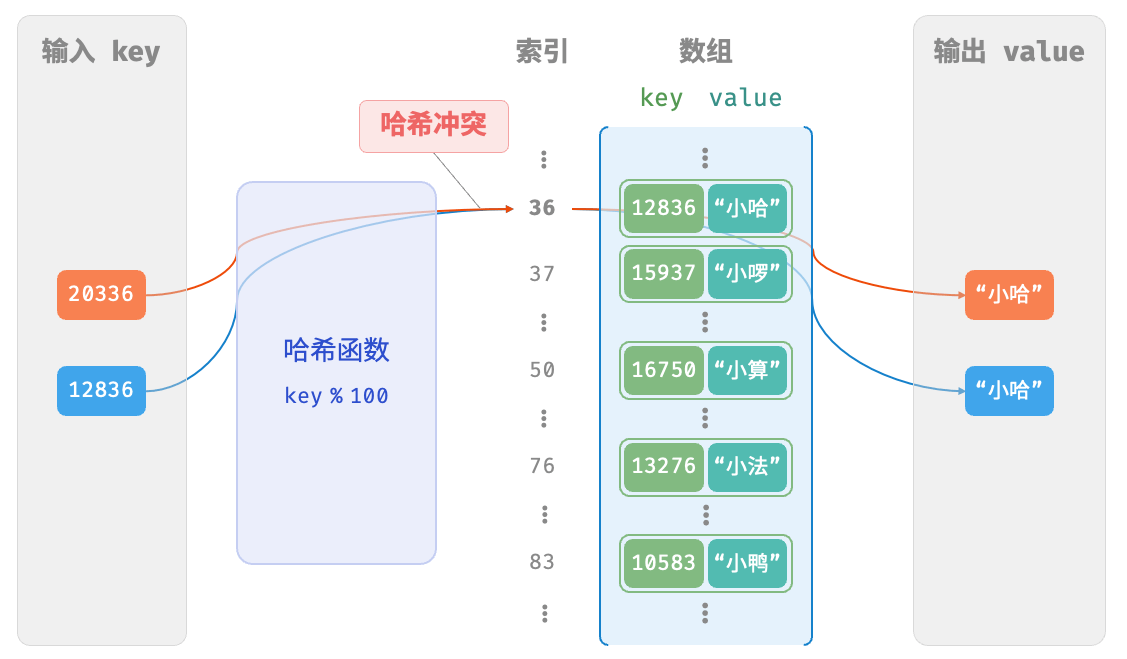
对于上述示例中的哈希函数,当输入的 key 后两位相同时,哈希函数的输出结果也相同。例如,查询学号为 12836 和 20336 的两个学生时,我们得到:
12836 % 100 = 3620336 % 100 = 36如图所示,两个学号指向了同一个姓名,这显然是不对的。我们将这种多个输入对应同一输出的情况称为「哈希冲突 hash collision」。
容易想到,哈希表容量 n 越大,多个 key 被分配到同一个桶中的概率就越低,冲突就越少。因此,我们可以通过扩容哈希表来减少哈希冲突。
如图所示,扩容前键值对 (136, A) 和 (236, D) 发生冲突,扩容后冲突消失。
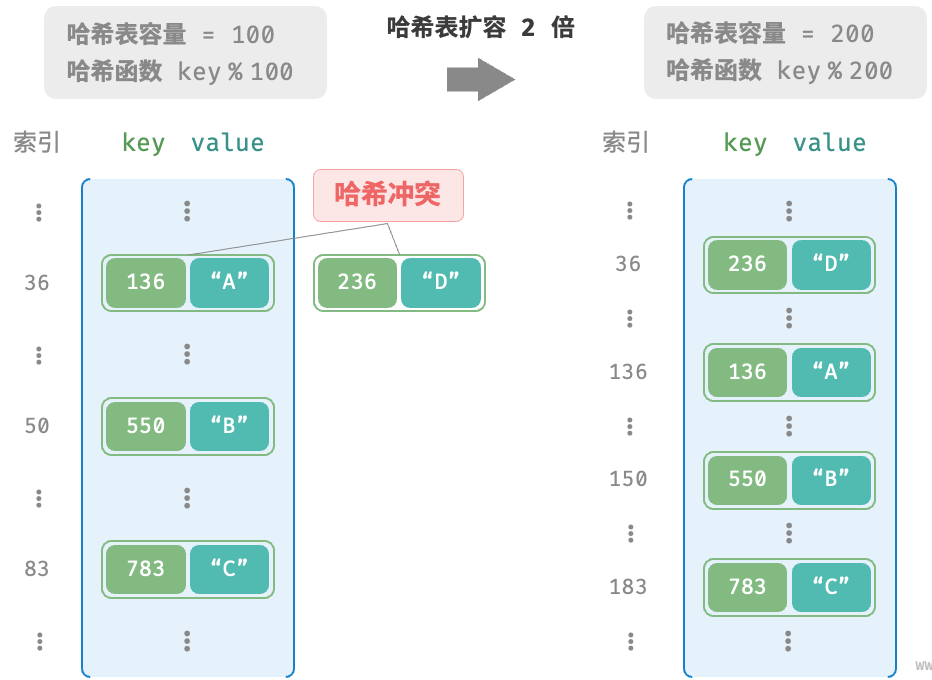
类似于数组扩容,哈希表扩容需将所有键值对从原哈希表迁移至新哈希表,非常耗时;并且由于哈希表容量 capacity 改变,我们需要通过哈希函数来重新计算所有键值对的存储位置,这进一步增加了扩容过程的计算开销。为此,编程语言通常会预留足够大的哈希表容量,防止频繁扩容。
**「负载因子 load factor」**是哈希表的一个重要概念,其定义为哈希表的元素数量除以桶数量,用于衡量哈希冲突的严重程度,也常作为哈希表扩容的触发条件。例如在 Java 中,当负载因子超过 0.75 时,系统会将哈希表扩容至原先的 2 倍。
哈希冲突
跳转到“哈希冲突”通常情况下哈希函数的输入空间远大于输出空间,因此理论上哈希冲突是不可避免的。比如,输入空间为全体整数,输出空间为数组容量大小,则必然有多个整数映射至同一桶索引。每当遇到哈希冲突时,哈希表扩容,直至冲突消失为止。此方法简单粗暴且有效,但效率太低。为了提升效率,我们可以采用以下策略。
- 改良哈希表数据结构,使得哈希表可以在出现哈希冲突时正常工作。
- 仅在必要时,即当哈希冲突比较严重时,才执行扩容操作。
哈希表的结构改良方法主要包括“链式地址”和“开放寻址”。
链式地址
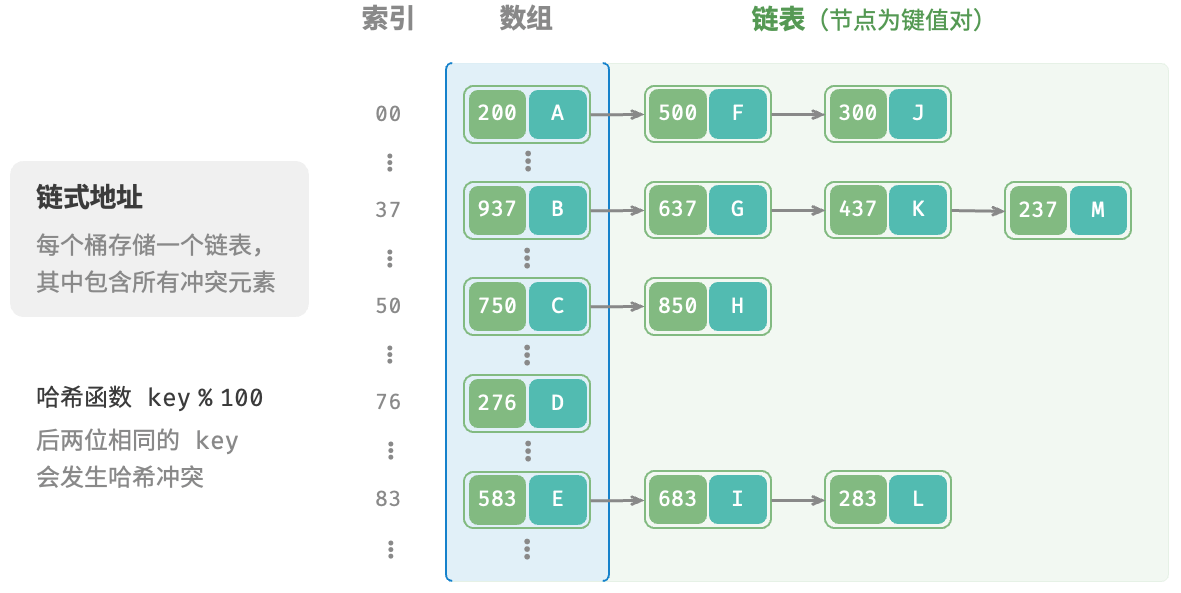
跳转到“链式地址”在原始哈希表中,每个桶仅能存储一个键值对。「链式地址 separate chaining」将单个元素转换为链表,将键值对作为链表节点,将所有发生冲突的键值对都存储在同一链表中。图展示了一个链式地址哈希表的例子。
然而,线性探测容易产生“聚集现象”。具体来说,数组中连续被占用的位置越长,这些连续位置发生哈希冲突的可能性越大,从而进一步促使该位置的聚堆生长,形成恶性循环,最终导致增删查改操作效率劣化。值得注意的是,我们不能在开放寻址哈希表中直接删除元素。这是因为删除元素会在数组内产生一个空桶 None ,而当查询元素时,线性探测到该空桶就会返回,因此在该空桶之下的元素都无法再被访问到,程序可能误判这些元素不存在,如图所示。
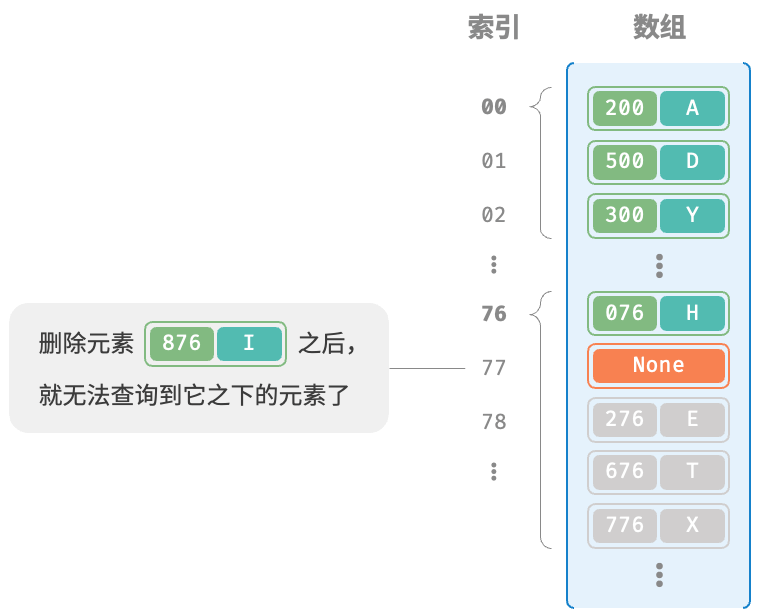
为了解决该问题,我们可以采用**「懒删除 lazy deletion」机制**:它不直接从哈希表中移除元素,而是利用一个常量 TOMBSTONE 来标记这个桶。在该机制下,None 和 TOMBSTONE 都代表空桶,都可以放置键值对。但不同的是,线性探测到 TOMBSTONE 时应该继续遍历,因为其之下可能还存在键值对。
然而,懒删除可能会加速哈希表的性能退化。这是因为每次删除操作都会产生一个删除标记,随着 TOMBSTONE 的增加,搜索时间也会增加,因为线性探测可能需要跳过多个 TOMBSTONE 才能找到目标元素。
为此,考虑在线性探测中记录遇到的首个 TOMBSTONE 的索引,并将搜索到的目标元素与该 TOMBSTONE 交换位置。这样做的好处是当每次查询或添加元素时,元素会被移动至距离理想位置(探测起始点)更近的桶,从而优化查询效率。
以下代码实现了一个包含懒删除的开放寻址(线性探测)哈希表。为了更加充分地使用哈希表的空间,我们将哈希表看作一个“环形数组”,当越过数组尾部时,回到头部继续遍历。
/* 开放寻址哈希表 */class HashMapOpenAddressing {  private:    int size;                             // 键值对数量    int capacity = 4;                     // 哈希表容量    const double loadThres = 2.0 / 3.0;     // 触发扩容的负载因子阈值    const int extendRatio = 2;            // 扩容倍数    vector<Pair *> buckets;               // 桶数组    Pair *TOMBSTONE = new Pair(-1, "-1"); // 删除标记
  public:    /* 构造方法 */    HashMapOpenAddressing() : size(0), buckets(capacity, nullptr) {    }
    /* 析构方法 */    ~HashMapOpenAddressing() {        for (Pair *pair : buckets) {            if (pair != nullptr && pair != TOMBSTONE) {                delete pair;            }        }        delete TOMBSTONE;    }
    /* 哈希函数 */    int hashFunc(int key) {        return key % capacity;    }
    /* 负载因子 */    double loadFactor() {        return (double)size / capacity;    }
    /* 搜索 key 对应的桶索引 */    int findBucket(int key) {        int index = hashFunc(key);        int firstTombstone = -1;        // 线性探测,当遇到空桶时跳出        while (buckets[index] != nullptr) {            // 若遇到 key ,返回对应的桶索引            if (buckets[index]->key == key) {                // 若之前遇到了删除标记,则将键值对移动至该索引处                if (firstTombstone != -1) {                    buckets[firstTombstone] = buckets[index];                    buckets[index] = TOMBSTONE;                    return firstTombstone; // 返回移动后的桶索引                }                return index; // 返回桶索引            }            // 记录遇到的首个删除标记            if (firstTombstone == -1 && buckets[index] == TOMBSTONE) {                firstTombstone = index;            }            // 计算桶索引,越过尾部则返回头部            index = (index + 1) % capacity;        }        // 若 key 不存在,则返回添加点的索引        return firstTombstone == -1 ? index : firstTombstone;    }
    /* 查询操作 */    string get(int key) {        // 搜索 key 对应的桶索引        int index = findBucket(key);        // 若找到键值对,则返回对应 val        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {            return buckets[index]->val;        }        // 若键值对不存在,则返回空字符串        return "";    }
    /* 添加操作 */    void put(int key, string val) {        // 当负载因子超过阈值时,执行扩容        if (loadFactor() > loadThres) {            extend();        }        // 搜索 key 对应的桶索引        int index = findBucket(key);        // 若找到键值对,则覆盖 val 并返回        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {            buckets[index]->val = val;            return;        }        // 若键值对不存在,则添加该键值对        buckets[index] = new Pair(key, val);        size++;    }
    /* 删除操作 */    void remove(int key) {        // 搜索 key 对应的桶索引        int index = findBucket(key);        // 若找到键值对,则用删除标记覆盖它        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {            delete buckets[index];            buckets[index] = TOMBSTONE;            size--;        }    }
    /* 扩容哈希表 */    void extend() {        // 暂存原哈希表        vector<Pair *> bucketsTmp = buckets;        // 初始化扩容后的新哈希表        capacity *= extendRatio;        buckets = vector<Pair *>(capacity, nullptr);        size = 0;        // 将键值对从原哈希表搬运至新哈希表        for (Pair *pair : bucketsTmp) {            if (pair != nullptr && pair != TOMBSTONE) {                put(pair->key, pair->val);                delete pair;            }        }    }
    /* 打印哈希表 */    void print() {        for (Pair *pair : buckets) {            if (pair == nullptr) {                cout << "nullptr" << endl;            } else if (pair == TOMBSTONE) {                cout << "TOMBSTONE" << endl;            } else {                cout << pair->key << " -> " << pair->val << endl;            }        }    }};
平方探测
跳转到“平方探测”平方探测与线性探测类似,都是开放寻址的常见策略之一。当发生冲突时,平方探测不是简单地跳过一个固定的步数,而是跳过“探测次数的平方”的步数,即 1,4,9,… 步。
平方探测主要具有以下优势。
- 平方探测通过跳过探测次数平方的距离,试图缓解线性探测的聚集效应。
- 平方探测会跳过更大的距离来寻找空位置,有助于数据分布得更加均匀。
然而,平方探测并不是完美的。
- 仍然存在聚集现象,即某些位置比其他位置更容易被占用。
- 由于平方的增长,平方探测可能不会探测整个哈希表,这意味着即使哈希表中有空桶,平方探测也可能无法访问到它。
多次哈希
跳转到“多次哈希”顾名思义,多次哈希方法使用多个哈希函数 f1(x)、f2(x)、f3(x)、… 进行探测。
- 插入元素:若哈希函数 f1(x)出现冲突,则尝试 f2(x),以此类推,直到找到空位后插入元素。
- 查找元素:在相同的哈希函数顺序下进行查找,直到找到目标元素时返回;若遇到空位或已尝试所有哈希函数,说明哈希表中不存在该元素,则返回
None。
与线性探测相比,多次哈希方法不易产生聚集,但多个哈希函数会带来额外的计算量。
请注意,开放寻址(线性探测、平方探测和多次哈希)哈希表都存在“不能直接删除元素”的问题。