模型导出与部署:PyTorch、ONNX 到 TensorRT
先分清三种产物
跳转到“先分清三种产物”常见部署路线是 PyTorch 模型 → ONNX 图 → 目标环境的 TensorRT engine。这是逐步导出、优化和编译的过程,不是三个文件格式可以任意无损往返。
| 产物 | 主要用途 | 必须额外保留 |
|---|---|---|
| PyTorch 模型与 checkpoint | 训练、微调、导出 | 模型代码、完整权重、配置及预处理 |
| ONNX 模型 | 描述运算图和参数,交给兼容后端 | IR/opset、外部权重、输入输出约定 |
| TensorRT engine / plan | 在兼容目标环境中高效推理 | GPU/软件版本、构建选项、插件和数值验收结果 |
engine 通常不能恢复出完整的训练工程;ONNX 也不会自动保存你的数据加载、标签语义和所有 Python 控制逻辑。若要更新模型,应从可追溯的源模型重新导出。
flowchart LR A["源模型 + 权重 + 输入约定"] --> B["导出 ONNX"] B --> C["结构检查 + 原框架数值对照"] C --> D["可选图简化 + 再验证"] D --> E["目标环境构建 engine"] E --> F["任务精度 + 延迟 + 内存验收"]第一步:把输入输出约定写清楚
跳转到“第一步:把输入输出约定写清楚”同一个形状也可能有不同含义。例如 float32[1,3,128,128] 可以表示 RGB,也可能表示 XYZ 点图。模型文件不能替你猜出以下信息:
- 输入名称、dtype、布局、批量与空间尺寸范围。
- RGB/BGR、像素/米/毫米、深度无效值等约定。
- resize、裁剪、归一化和坐标变换的先后顺序。
- 每个输出代表分类、位置、方向、掩码还是中间特征。
- 阈值、类别编号及后处理所用坐标系。
输入数据和基准输出应作为测试样本保存;用纯随机数据“跑通”只能证明部分接口兼容,不能证明业务正确。
第二步:导出 PyTorch 模型
跳转到“第二步:导出 PyTorch 模型”以下采用官方 torch.export 路线的 dynamo=True 接口,演示动态批量的仿射模型。导出器依赖和具体支持范围应匹配实际安装的 PyTorch 版本。PyTorch ONNX 导出文档
import numpy as npimport onnximport onnxruntime as ortimport torch
class Affine(torch.nn.Module):    def forward(self, x):        return 2 * x + 1
model = Affine().eval()sample = torch.zeros(2, 3, dtype=torch.float32)batch = torch.export.Dim("batch", min=1, max=8)torch.onnx.export(    model, (sample,), "affine.torch.onnx",    input_names=["x"], output_names=["y"],    opset_version=18, dynamo=True,    dynamic_shapes=({0: batch},),)onnx.checker.check_model(onnx.load("affine.torch.onnx"), full_check=True)session = ort.InferenceSession(    "affine.torch.onnx", providers=["CPUExecutionProvider"])for n in (1, 2, 8):    x = torch.arange(n * 3, dtype=torch.float32).reshape(n, 3) / 4    with torch.no_grad():        expected = model(x).numpy()    actual = session.run(["y"], {"x": x.numpy()})[0]    np.testing.assert_allclose(actual, expected, rtol=1e-6, atol=1e-6)
eval() 切换 Dropout、BatchNorm 等模块的推理行为;no_grad() 控制执行时的梯度记录,两者用途不同。动态尺寸也不是把所有维度都改成未知就结束:导出约束、ONNX 图和目标引擎的允许范围必须相容,应用层仍应检查输入边界。
旧 dynamic_axes 示例属于另一条导出接口语境,不应和 dynamo=True 的 dynamic_shapes 不加区分地混用。算子无法导出时,先定位不支持的算子或数据相关控制流,再决定改写或使用适配方案,不能靠盲目降低 opset 解决所有问题。
本次环境未安装 PyTorch,因此上述框架导出程序未执行;已执行的 CPU 基线在 ONNX、ORT 和 图简化 三篇中。
原 ES6D 记录中需要保留的约束
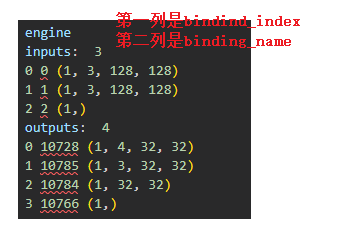
跳转到“原 ES6D 记录中需要保留的约束”旧实验使用 ES6D(num_class=2),输入包含 RGB、深度表示和类别编号,导出文件名为 estimator_weigh.onnx。原代码只按名称筛选 checkpoint 键,再用筛选结果覆盖初始化权重。这可能遗漏参数而仍继续导出。
重新运行该项目时应:
- 固定原模型源码版本,确认 checkpoint 对应的模型配置。
- 对匹配架构严格加载权重;若确需迁移学习,逐项记录缺失键、多余键、形状差异和处理原因。
- 检查原代码把“depth”构造为三通道随机数组的真实含义;不能据此认定传感器深度数据应这样预处理。
- 记录 RGB、depth、class 三个真实输入的名称、类型和语义,而不依赖导出器临时生成的编号。
- 对每个输出做源框架、ONNX 与目标引擎的逐级比较。
下图是旧记录中的一次 128×128 输入检查,包含两个图像状输入、一个类别输入和四个输出。旧文另一段 448×448、三个同形输入的文字日志属于不同接口示例,不能把二者拼成同一个模型的规格。
第三步:在目标环境构建 TensorRT engine
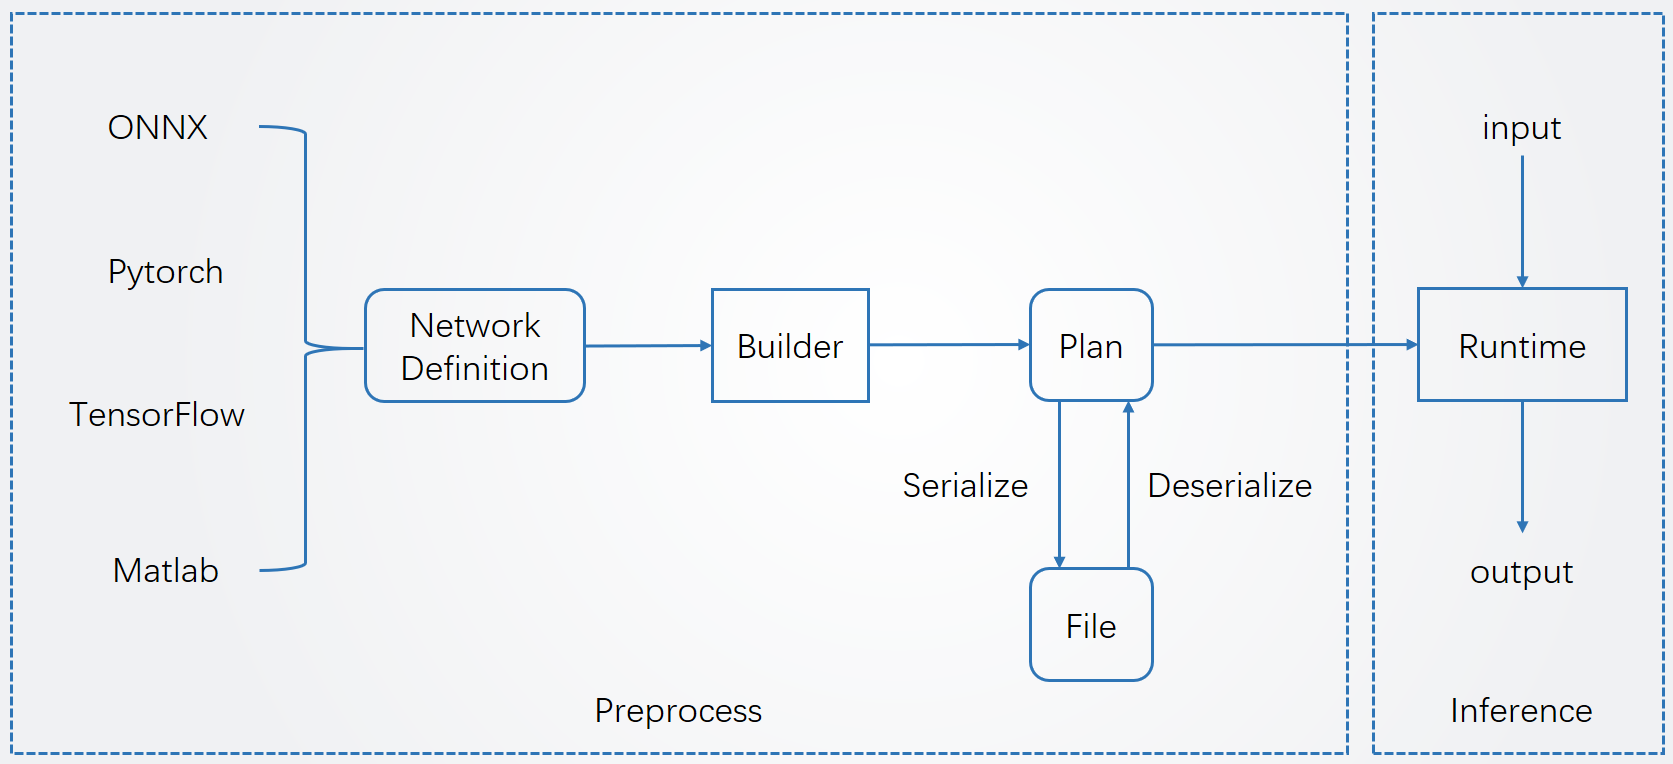
跳转到“第三步:在目标环境构建 TensorRT engine”构建器读取模型、支持范围、形状 profile 和资源预算,选择执行实现并生成序列化 engine。运行时反序列化后创建 execution context;两阶段应分开理解。
以下命令以 x 为真实输入名,声明最小、优化和最大批量分别为 1、2、8。执行前先核对安装版本的 trtexec --help:
trtexec --onnx=affine.torch.onnx --minShapes=x:1x3 --optShapes=x:2x3 --maxShapes=x:8x3 --saveEngine=affine.planprofile 必须覆盖真实请求尺寸;静态维不能任意改成另一数值。若构建失败,先看 parser 错误和实际输入形状,不要继续把空返回值写成“成功”的 engine 文件。
旧 Python 片段把 workspace=2 乘以 ,实际预算是 2 MiB;不是注释中的 2 字节,也不是 2 GiB。不同大版本的 workspace 接口和命令行参数已经变化,应使用该版本的内存池配置,并记录单位。workspace 也不等于整个进程的 GPU 内存上限。
优化为什么可能更快
跳转到“优化为什么可能更快”层融合可能减少 kernel 启动和中间数据读写。一个融合后的 CUDA kernel 是并行执行的一段设备程序,不是“只占一个硬件 CUDA core”;不能按图中层数估算使用了几个 CUDA core。
TensorRT 还会选择适合目标硬件的实现、内存布局和执行策略。降低精度可能减少计算和存储成本,但会引入误差,且收益依赖算子、硬件和数据规模。性能优化说明
| 环境 | 精度配置的注意点 |
|---|---|
| TensorRT 8.x/10.x 的相关旧流程 | 常见 --fp16、INT8 校准或构建 flag,须按版本及图类型确认 |
| TensorRT 11.x | 强类型图;旧 --fp16、--int8 等精度开关已移除,应先准备所需精度/量化表达的模型 |
原代码只启用 INT8 flag 却没有把校准器交给配置,不能视为完成了 INT8 校准。量化输入代表性、缩放参数及精度回归都不能省略。11.x 迁移说明
第四步:运行、同步和验收
跳转到“第四步:运行、同步和验收”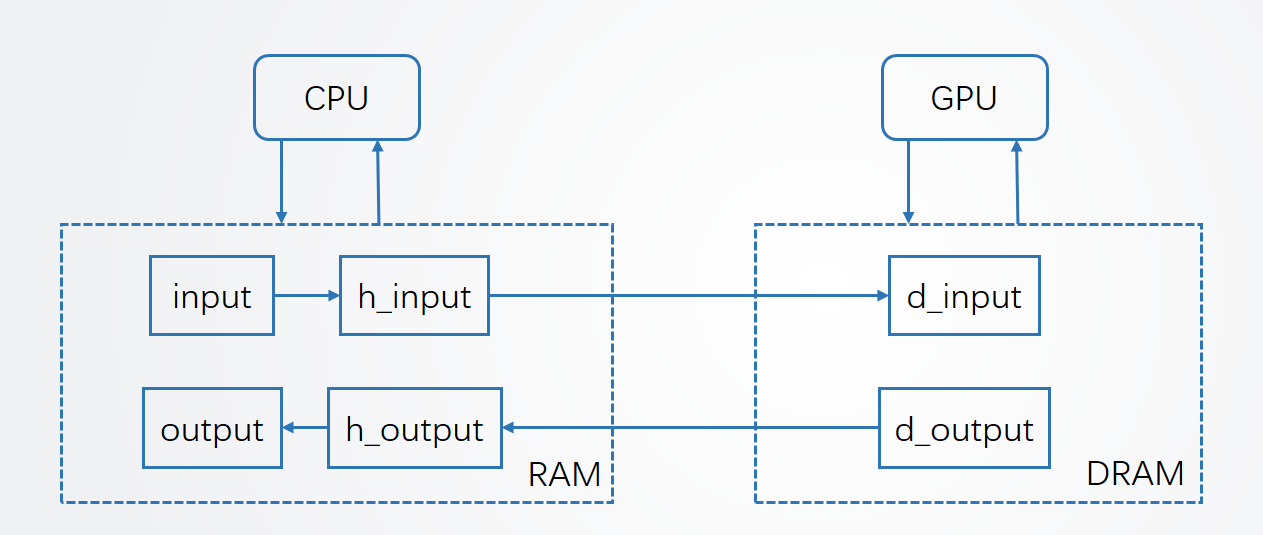
输入准备、主机到设备拷贝、推理、设备到主机拷贝和后处理构成完整请求流程。异步提交结束不代表 GPU 工作完成;在消费输出、回收内存或停止计时前要满足同步条件。命名张量、地址绑定和 8.x/10.x API 对照集中见 TensorRT 运行时。
发布前至少保留这四类结果:
- 正确性:代表性样本的逐输出误差与任务指标。
- 形状范围:最小、典型、最大尺寸,以及超范围输入的拒绝行为。
- 性能:预热、批量、并发、拷贝是否包含、延迟分位数和峰值内存。
- 可复现性:源提交、权重/模型哈希、环境版本、插件、构建命令和测试集说明。
本页不提供一个未经实测的 ES6D engine,也不声称已经在 GPU 上验证延迟。
历史资料如何使用
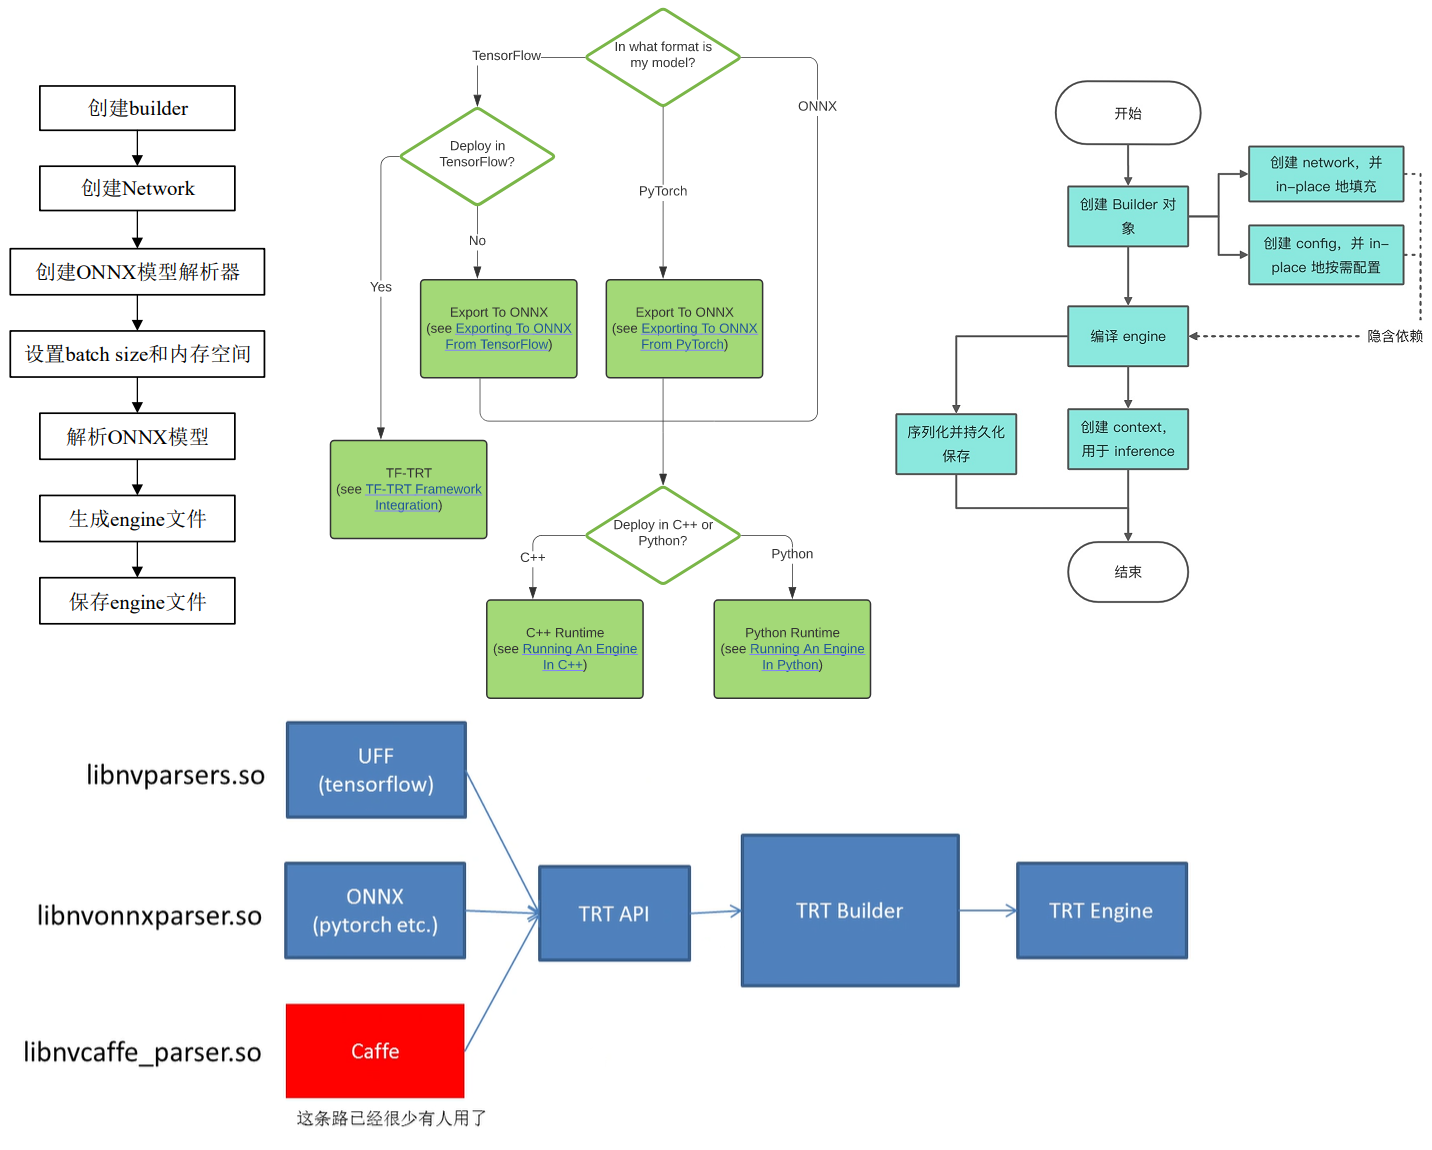
跳转到“历史资料如何使用”下图保留原笔记的多种构建流程,其中包含 UFF、Caffe 和旧解析库。它用于理解历史项目,不代表当前 TensorRT 版本仍提供这些入口。
旧笔记曾参考 部署 TensorRT 加速记录 和 TensorRT Python 使用记录。这些链接保留来源线索;API 迁移与当前行为以对应版本的官方文档为准。