振动监测系统:数据契约、报警与机器学习验证
一个可用的监测系统必须能够解释数据来自哪里、怎样计算、为何报警,以及升级后结果是否仍可比较。算法准确率只是其中一项;丢帧、单位错配和工况变化都可能使后续判断失效。
1. 明确各层职责
跳转到“1. 明确各层职责”flowchart LR A["传感器与同步采集"] --> B["边缘缓冲与质量标记"] B --> C["原始数据与元数据存储"] B --> D["版本化特征计算"] D --> E["工况基线、规则与模型"] E --> F["报警事件与人工复核"] F --> G["工单、检修与复验"] G --> C采集层处理驱动、时钟、触发与溢出;分析层处理分段、滤波和特征;评价层处理标准条件、基线和模型;业务层记录复核、工单与维修结果。不要让一个 UI 按钮同时隐式改变所有层的参数。
DAQ 设备接口取决于具体硬件和驱动,可能采用厂商 SDK、USB、网络或 VISA。原稿中一个虚构库的 collect 或 calibrate 调用,以及每秒执行一次 READ? 的片段,都不能证明已完成同步高速振动采集。应用刷新速度也不等于硬件采样率。
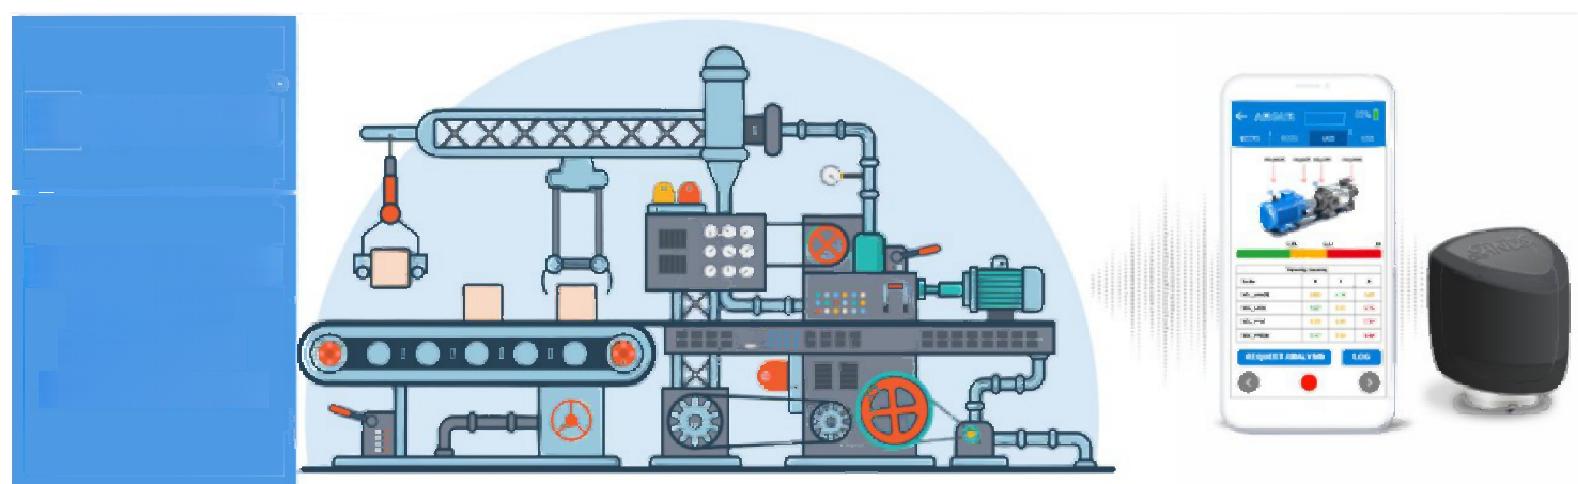
旧图表达“设备数据可在终端查看”的架构意图,不代表已部署项目或已验证性能。
2. 先算数据量,再选链路
跳转到“2. 先算数据量,再选链路”若通道数为 、每通道采样率为 、每个样本存储 字节,则原始载荷速率:
例如 8 通道、25,600 samples/s、每点按 4 字节存储,得到 bytes/s;一天原始载荷约 GB(十进制),还未计文件头、索引、协议与副本。ADC 是 24 位不意味着传输一定是每点 3 字节,应按实际封装计算。
高采样原始流、周期特征和报警事件可以走不同存储策略。边缘缓存吸收短时网络中断,序列号暴露丢帧,重传与去重保证事件一致性;过载时需明确丢弃策略并产生质量标记。
Wi-Fi、蜂窝或低功耗无线是链路选择;MQTT、CoAP 等是上层协议,不能直接称为“无线采样协议”。链路带宽、延时、时钟同步和能耗应由测量需求决定。低功耗节点的周期休眠不适合所有瞬态捕获任务。
3. 最小数据契约
跳转到“3. 最小数据契约”下面仅为教学元数据,原始数组应另存文件或数据块。时间起点与样本时钟要共同定义,不能靠每个包到达服务器的时刻拼成等间隔波形。
{ "schema_version": 1, "record_id": "demo-bearing-a-001", "asset_id": "demo-motor", "point": "drive_end_horizontal", "start_time_utc": "2026-10-02T12:00:00Z", "sample_rate_hz": 25600, "sample_count": 256000, "quantity": "acceleration", "unit": "m/s^2", "sample_format": "float32_le", "sensor_id": "demo-sensor", "mount": "stud", "speed_rpm": 1800, "load_percent": 70, "quality": {"clipped": false, "missing_samples": 0}, "processing_version": "demo-v1", "raw_file": "record-001.bin"}实际还应记录灵敏度、调理增益、校准记录、模拟带宽、同步源、原始数据校验值以及处理版本。校验和用于发现损坏和关联数据,不等于加密或访问权限。
每个特征应有名称、量纲、频带、窗、记录长度、算法版本和质量状态。不能把“速度 RMS,10–1000 Hz”与“加速度全带 RMS”都只存为一个 rms 字段。
4. 报警是有状态的决策
跳转到“4. 报警是有状态的决策”单次超限可能来自启停、传感器移动或通信异常。设计规则时应明确:
- 规则适用的设备、工况、测点、物理量和频带。
- 触发阈值、持续时间、连续次数、回落阈值与迟滞。
- 数据无效、设备停机、维护中时如何处理。
- 报警去重、升级、确认与关闭条件。
- 报警事件引用哪些原始记录,如何复算。
这些配置来自适用标准、制造商资料、现场基线和项目约定,不能从教程随意取一组数值。健康状态分类和保护停机也不是同一个软件功能;云端分析与界面刷新不能自动证明硬实时保护能力。
趋势变更要可追溯。更换传感器、修改滤波、量程、特征或模型后,应标记版本并做对照,避免把算法变化当成设备恶化。
5. 区分机器学习任务
跳转到“5. 区分机器学习任务”| 任务 | 标签与输入要求 | 能回答什么 |
|---|---|---|
| 故障分类 | 经过确认的状态标签与对应记录 | 更像哪一类已学过的状态 |
| 异常检测 | 可代表正常工况的基线 | 与已知正常分布有多大差异 |
| 趋势预测 | 有时间顺序、工况一致的历史序列 | 某特征未来可能怎样变化 |
| 剩余寿命预测 | 退化、失效时间、删失与维护信息 | 在模型条件下估计寿命分布 |
SVM、决策树、随机森林和 MLP 可用于分类;LSTM 可用于序列建模;算法名称本身不能证明完成了寿命预测。AR/MA/ARMA 等也有统计假设与残差检查要求。模型训练并不提高传感器的物理测量精度。
PCA、归一化、特征选择和调参必须在训练数据上拟合。一次长记录切成相邻窗口后随机分到训练集与测试集,会让非常相似的片段泄漏到两边;按设备、试验批次或时间划分通常更符合实际验证问题。分组测试也不自动代表跨工厂、跨转速的泛化。GroupShuffleSplit 官方说明
6. 可运行的分组验证实验
跳转到“6. 可运行的分组验证实验”下面人为生成 20 台“虚拟设备”,每台 10 段波形。标签 1 只表示生成时额外加入了脉冲,标签 0 表示未加入;它们不是实际轴承健康/故障标签。需要 NumPy 和 scikit-learn。
import numpy as npfrom sklearn.model_selection import GroupShuffleSplitfrom sklearn.pipeline import make_pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.svm import SVCfrom sklearn.metrics import classification_report
rng = np.random.default_rng(42)fs = 1024.0t = np.arange(512) / fsfeatures, labels, groups = [], [], []
for machine in range(20):    gain = rng.uniform(0.8, 1.2)    for segment in range(10):        label = segment % 2        x = gain*np.sin(2*np.pi*50*t + rng.uniform(0, 2*np.pi))        x += rng.normal(0, 0.1, t.size)        if label == 1:            locations = rng.choice(t.size, 4, replace=False)            x[locations] += rng.uniform(3, 5, 4)        x -= x.mean()        rms = np.sqrt(np.mean(x*x))        peak = np.max(np.abs(x))        kurtosis = np.mean(x**4) / np.mean(x*x)**2        features.append([rms, peak/rms, kurtosis])        labels.append(label)        groups.append(machine)
X, y, group = np.asarray(features), np.asarray(labels), np.asarray(groups)splitter = GroupShuffleSplit(n_splits=1, test_size=0.25, random_state=7)train, test = next(splitter.split(X, y, groups=group))assert not set(group[train]) & set(group[test])assert set(y[train]) == {0, 1} and set(y[test]) == {0, 1}
model = make_pipeline(StandardScaler(), SVC(kernel="rbf", C=1.0))model.fit(X[train], y[train])predicted = model.predict(X[test])print("训练设备数:", len(set(group[train])))print("测试设备数:", len(set(group[test])))print(classification_report(y[test], predicted, zero_division=0))
这个例子的分离很容易,因为脉冲是人为显著注入的。即使结果很好,也只能验证代码和划分流程,不能作为现场诊断准确率。真实验证还应报告每类召回率、精确率、混淆矩阵、漏报与误报代价,以及未见工况的表现。
测试集用于最后评价,不能反复据其结果挑模型。需要调参时,在训练集内部再做符合设备或时间边界的验证;部署后还要监测分布变化和标签质量。
7. 集成、权限与可恢复性
跳转到“7. 集成、权限与可恢复性”与 MES、EAM 或工单系统对接时,交换设备标识、事件时间、严重度、证据位置和处置状态。OPC UA、REST 或消息接口的选择不能省略单位、时间、质量码和版本契约。
传输使用经过验证的加密与认证通道,设备和服务采用独立身份与最小权限。密钥保存在受控配置或密钥管理系统中,不进入笔记、截图或日志。
原稿的 AES 片段只演示分组加解密,缺少完整性认证和密钥生命周期,不能直接当生产安全方案。需要应用层加密时,采用经过审查的认证加密实现并处理 nonce 与认证标签等规则;例如 .NET 的 AesGcm 提供对应接口。IV/nonce 通常不是需要保密的密钥,但必须满足所用模式的要求;不能把它与密钥混为一谈。
系统升级应保留数据格式兼容、配置审计、备份与恢复演练。存储压力由原始流大小、保留期、事件截取和副本策略管理,不靠无差别删除历史数据解决。
8. 验收与学习路线
跳转到“8. 验收与学习路线”验收应从已知输入开始:检查单位链、采样率、丢帧、削顶、同步、FFT 幅值、特征版本、报警状态机、断网恢复和数据复算。没有连接真实设备的模拟程序,应明确标记为离线演示。
软件选择先看硬件驱动支持、数据导出、算法定义、批处理和可追溯性,再看界面与扩展性。不要把无来源的“某软件 v1.0—v4.2 历史表”当作真实产品沿革,也不要用模型名称代替案例证据。
专业学习可按测量—信号处理—机械机理—诊断案例—验证方法推进。原稿的证书归属需要纠正:NVLAP 是实验室认可项目;CMRP 是维护与可靠性相关人员认证,不能把二者列成 ISO 或 ASME 颁发的同类“振动分析师证书”。选择课程时核验实际机构、能力范围和考核要求。