栈
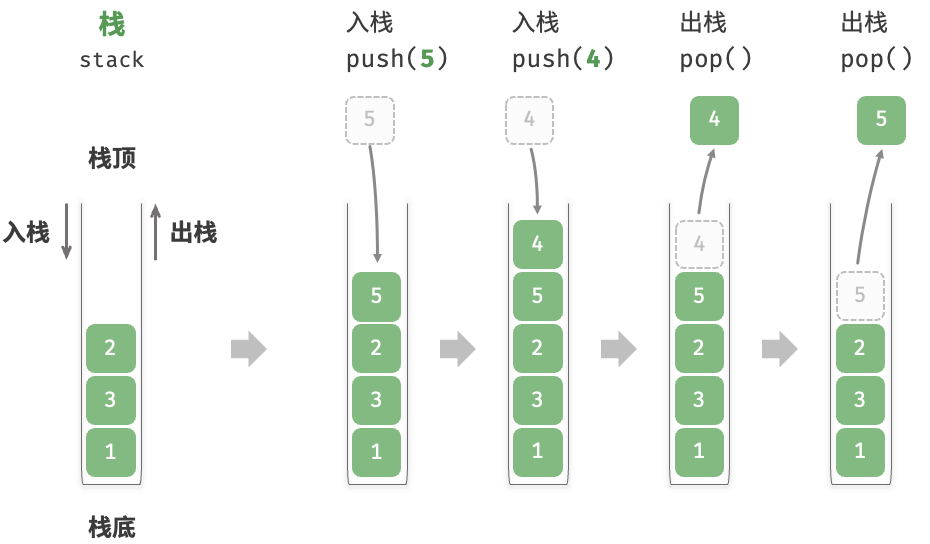
**「栈 stack」**是一种遵循先入后出逻辑的线性数据结构。栈类比为桌面上的一摞盘子,如果想取出底部的盘子,则需要先将上面的盘子依次移走。
把堆叠元素的顶部称为**“栈顶”,底部称为“栈底”。将把元素添加到栈顶的操作叫作“入栈”,删除栈顶元素的操作叫作出栈**。
栈的常用操作
跳转到“栈的常用操作”栈的常用操作如表 5-1 所示,具体的方法名需要根据所使用的编程语言来确定。在此,我们以常见的 push()、pop()、peek() 命名为例。通常情况下,可以直接使用编程语言内置的栈类。然而,某些语言可能没有专门提供栈类,这时可以将该语言的“数组”或“链表”当作栈来使用,并在程序逻辑上忽略与栈无关的操作。
表 5-1 栈的操作效率
| 方法 | 描述 | 时间复杂度 |
|---|---|---|
push() | 元素入栈(添加至栈顶) | O(1) |
pop() | 栈顶元素出栈 | O(1) |
peek() | 访问栈顶元素 | O1) |
# 初始化栈# Python 没有内置的栈类,可以把 list 当作栈来使用stack: list[int] = []
# 元素入栈stack.append(1)stack.append(3)stack.append(2)stack.append(5)stack.append(4)
# 访问栈顶元素peek: int = stack[-1]
# 元素出栈pop: int = stack.pop()
# 获取栈的长度size: int = len(stack)
# 判断是否为空is_empty: bool = len(stack) == 0
栈的实现&应用
跳转到“栈的实现&应用”尝试自己实现一个栈类。栈遵循先入后出的原则,因此我们只能在栈顶添加或删除元素。然而,数组和链表都可以在任意位置添加和删除元素,因此栈可以视为一种受限制的数组或链表。
基于链表的实现
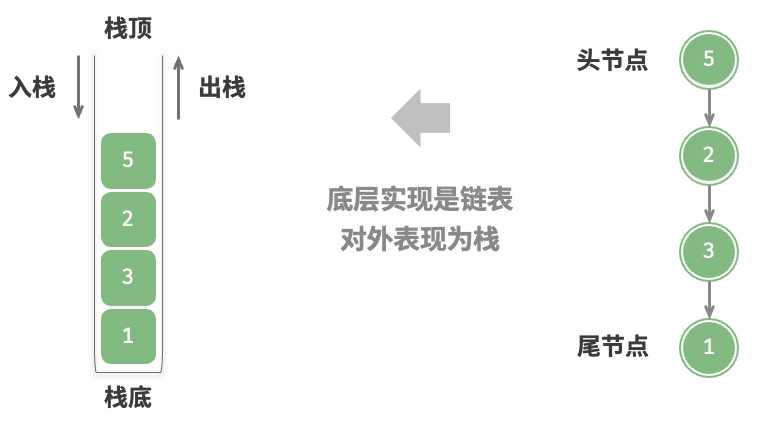
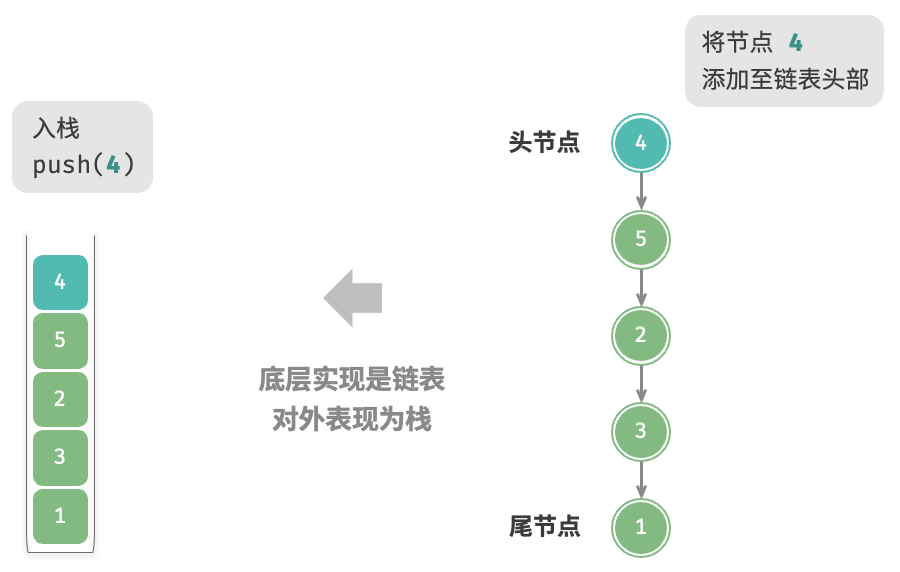
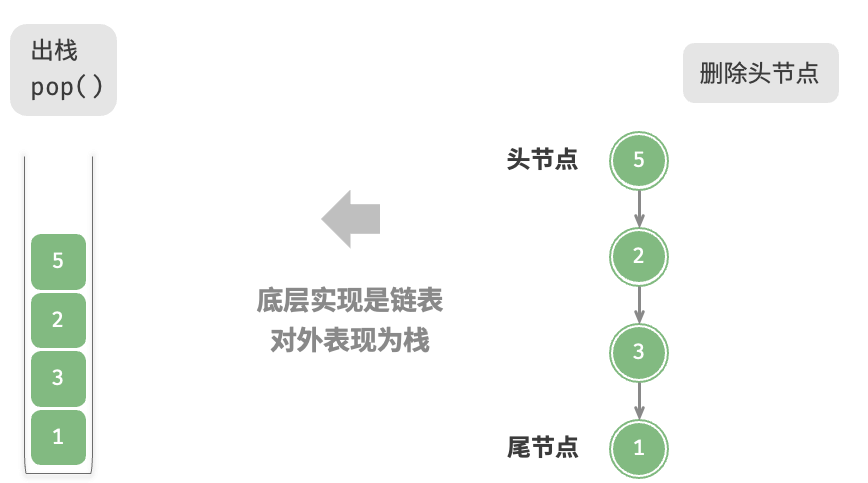
跳转到“基于链表的实现”使用链表实现栈时,我们可以将链表的头节点视为栈顶,尾节点视为栈底。
| LinkedListStack | push() | pop() |
|---|---|---|
 |  |  |
/* 基于链表实现的栈 */class LinkedListStack {  private:    ListNode *stackTop; // 将头节点作为栈顶    int stkSize;        // 栈的长度
  public:    LinkedListStack() {        stackTop = nullptr;        stkSize = 0;    }
    ~LinkedListStack() {        // 遍历链表删除节点,释放内存        freeMemoryLinkedList(stackTop);    }
    /* 获取栈的长度 */    int size() {        return stkSize;    }
    /* 判断栈是否为空 */    bool isEmpty() {        return size() == 0;    }
    /* 入栈 */    void push(int num) {        ListNode *node = new ListNode(num);        node->next = stackTop;        stackTop = node;        stkSize++;    }
    /* 出栈 */    int pop() {        int num = top();        ListNode *tmp = stackTop;        stackTop = stackTop->next;        // 释放内存        delete tmp;        stkSize--;        return num;    }
    /* 访问栈顶元素 */    int top() {        if (isEmpty())            throw out_of_range("栈为空");        return stackTop->val;    }
    /* 将 List 转化为 Array 并返回 */    vector<int> toVector() {        ListNode *node = stackTop;        vector<int> res(size());        for (int i = res.size() - 1; i >= 0; i--) {            res[i] = node->val;            node = node->next;        }        return res;    }};
基于数组的实现
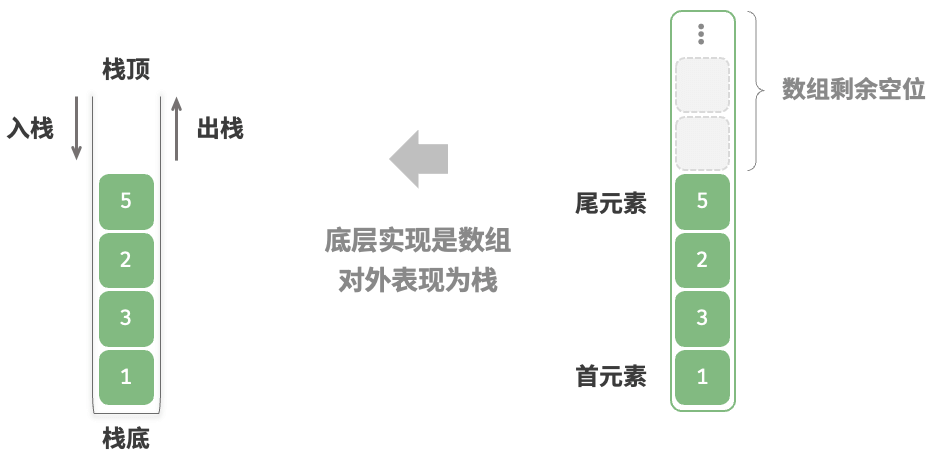
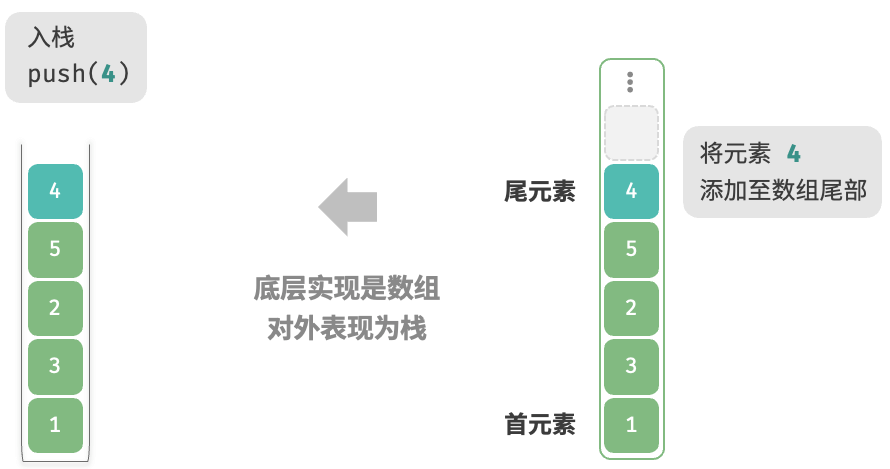
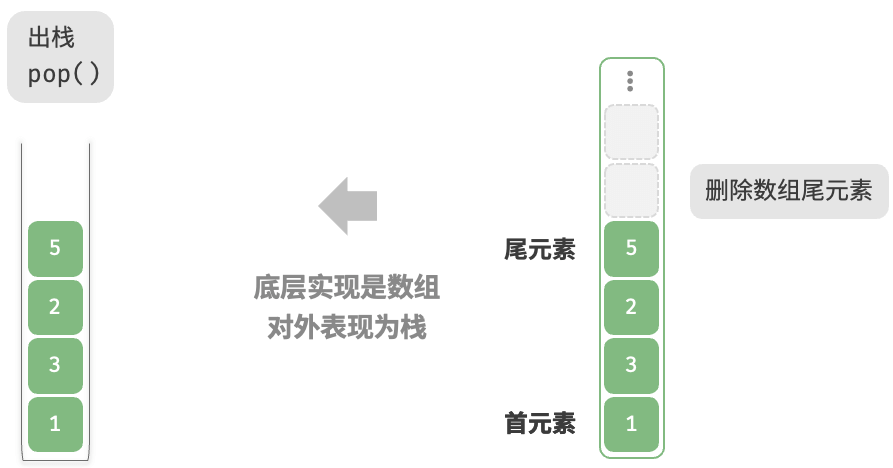
跳转到“基于数组的实现”使用数组实现栈时,我们可以将数组的尾部作为栈顶。入栈与出栈操作分别对应在数组尾部添加元素与删除元素,时间复杂度都为 O(1) 。
| ArrayStack | push() | pop() |
|---|---|---|
 |  |  |
/* 基于链表实现的栈 */class LinkedListStack {  private:    ListNode *stackTop; // 将头节点作为栈顶    int stkSize;        // 栈的长度
  public:    LinkedListStack() {        stackTop = nullptr;        stkSize = 0;    }
    ~LinkedListStack() {        // 遍历链表删除节点,释放内存        freeMemoryLinkedList(stackTop);    }
    /* 获取栈的长度 */    int size() {        return stkSize;    }
    /* 判断栈是否为空 */    bool isEmpty() {        return size() == 0;    }
    /* 入栈 */    void push(int num) {        ListNode *node = new ListNode(num);        node->next = stackTop;        stackTop = node;        stkSize++;    }
    /* 出栈 */    int pop() {        int num = top();        ListNode *tmp = stackTop;        stackTop = stackTop->next;        // 释放内存        delete tmp;        stkSize--;        return num;    }
    /* 访问栈顶元素 */    int top() {        if (isEmpty())            throw out_of_range("栈为空");        return stackTop->val;    }
/* 将 List 转化为 Array 并返回 */ vector<int> toVector() { ListNode *node = stackTop; vector<int> res(size()); for (int i = res.size() - 1; i >= 0; i--) { res[i] = node->val; node = node->next; } return res; }};(3)两种实现对比&典型应用
-
都支持栈定义中的各项操作
-
时间效率:基于数组的实现效率较高,然而,如果入栈时超出数组容量,会触发扩容机制,导致该次入栈操作的时间复杂度变为O(n) 。。基于链表的实现中,链表的扩容非常灵活,不存在上述数组扩容时效率降低的问题。但是,入栈操作需要初始化节点对象并修改指针,因此效率相对较低。综上所述,当入栈与出栈操作的元素是基本数据类型时,例如
int或double,我们可以得出以下结论。-
基于数组实现的栈在触发扩容时效率会降低,但由于扩容是低频操作,因此平均效率更高。
-
基于链表实现的栈可以提供更加稳定的效率表现。
-
-
空间效率,基于数组实现的栈可能造成一定的空间浪费。
应用
跳转到“应用”- 浏览器中的后退与前进、软件中的撤销与反撤销。每当我们打开新的网页,浏览器就会对上一个网页执行入栈,这样我们就可以通过后退操作回到上一个网页。后退操作实际上是在执行出栈。如果要同时支持后退和前进,那么需要两个栈来配合实现。
- 程序内存管理。每次调用函数时,系统都会在栈顶添加一个栈帧,用于记录函数的上下文信息。在递归函数中,向下递推阶段会不断执行入栈操作,而向上回溯阶段则会不断执行出栈操作。