PVNet 关键点投票异常:从求解器到最小二乘条件数
1. 保留的故障记录与证据边界
跳转到“1. 保留的故障记录与证据边界”原记录发表于 2024-08-08:在 NVIDIA Orin Nano 上,将基于 clean-pvnet 的自定义数据集流程改为 TensorRT/Python 后,mask 看起来正常,但由向量场投票得到的关键点严重偏离预期,最终位姿不准确。当时预计坐标为数百像素,日志却出现约两万的值,例如 (20114.7383, -663.1294)。
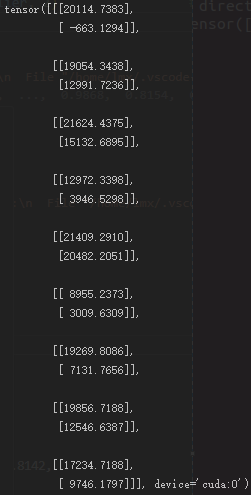
当时记录的处理是“将最后一步求解改为 QR 后恢复”。这个现象值得保留,但原稿没有保存失败样本的矩阵、修改前后代码、库版本、精度和评估结果,无法据此证明 LU 本身不适用于这类问题,也不能断言换 QR 就能修复所有异常。本文补充数学模型与可运行的局部检查;没有重新运行那份 TensorRT 引擎或原始数据集。
2. 投票后的精化为什么是最小二乘
跳转到“2. 投票后的精化为什么是最小二乘”对一个关键点,设前景像素位置为 ,预测单位方向为 。关键点 应落在从像素沿该方向延伸的直线上。取垂直法向量:
RANSAC 先找候选交点及其内点;只用选中的内点建立:
实际方向含噪声,直线通常不会精确相交。若有置信权重 ,应把第 行的 和 同时乘以 ;直接乘以 会改变预期权重。0/1 内点筛选是特殊情况。
本次检查 clean-pvnet 的 ransac_voting_gpu.py:代码把像素索引从行列顺序换成 (x,y),对内点法向量构造 ATA 与 ATb;不同函数分支使用矩阵求逆或旧 torch.solve 辅助函数。它说明实际移植需要逐步对齐什么,并不说明历史故障使用了完全相同的提交。应固定仓库提交再比较,不能只记录“基于 clean-pvnet”。上游实现
条件数比求解器名字更能解释失真
跳转到“条件数比求解器名字更能解释失真”法向量方向太接近时, 的两列接近线性相关;很多几乎平行的投票线也不能稳定确定二维交点。对于满列秩的实矩阵,以 2 范数计算:
因此先形成正规方程 会放大病态性,并在有限精度下损失有效信息。对**原始 **做 QR/SVD,可避免额外构造正规方程;对已经形成的 ATA 再做 QR,则不能恢复此前舍入丢失的信息。几何退化、错误坐标和外点也不会因为更换分解方法而消失。
3. LU 与 QR 各自在做什么
跳转到“3. LU 与 QR 各自在做什么”LU:方程求解与主元
跳转到“LU:方程求解与主元”无主元交换、 对角为 1 的 分解写作:
从 逐项比较可得:
这些公式要求相关主元非零。非奇异方阵的各阶顺序主子式非零,是这种无交换分解存在的条件;数值实现通常采用部分主元交换,写作 ,有些库使用等价但排列矩阵定义相反的 。必须以接口文档为准。LU 分解本身也可推广到矩形矩阵;“只适用于方阵”过于绝对,常见方阵线性方程求解才是这里的比较对象。SciPy LU 约定
对于良态、满秩的方阵系统,带主元的 LU 可以得到正确结果。这里更应避免显式求逆后再乘右端项,并先确认求解器究竟接收 A,还是 ATA。
QR:列正交与最小二乘
跳转到“QR:列正交与最小二乘”当 且 ,简约 QR 为:
这里 是列正交归一矩阵;矩形 一般不满足 ,不应不加区分地称为方形正交矩阵。满列秩时 非奇异,最小二乘解通过三角方程求出:
用 Gram–Schmidt 理解分解过程时,令 为 的第 列:
投影也可写成 ,因为 已归一化。这修复了原稿把下标写成星号的问题,并用 区分归一化之前的向量。若 ,不能继续相除;经典 Gram–Schmidt 在浮点病态问题中也可能丢失正交性。工程上使用库的 Householder QR、带列主元的 QR 或 SVD,并根据秩选择处理策略。NumPy QR、LAPACK 最小二乘驱动
4. 可运行的 CPU 参考:只验证内点精化
跳转到“4. 可运行的 CPU 参考:只验证内点精化”下面接收一个关键点、已经筛选好的内点,统一为 (x,y) 像素坐标和朝向关键点的方向。它不实现 mask、网络推理、RANSAC 或 PnP。使用 float64 建立调试基准;实际 GPU 流程是否能用相同精度、吞吐和 API 需另行评估。
import numpy as np
def refine_keypoint(points, directions, max_condition=1e8):    points = np.asarray(points, dtype=np.float64)    directions = np.asarray(directions, dtype=np.float64)    if points.ndim != 2 or points.shape[1] != 2:        raise ValueError("points must have shape (N, 2)")    if directions.shape != points.shape or len(points) < 2:        raise ValueError("need matching directions and at least two points")    if not np.isfinite(points).all() or not np.isfinite(directions).all():        raise ValueError("non-finite input")    if not np.isfinite(max_condition) or max_condition < 1:        raise ValueError("invalid condition limit")    lengths = np.linalg.norm(directions, axis=1)    if np.any(lengths == 0) or not np.isfinite(lengths).all():        raise ValueError("invalid direction length")    directions = directions / lengths[:, None]    A = np.column_stack((directions[:, 1], -directions[:, 0]))    b = np.sum(A * points, axis=1)    if not np.isfinite(b).all():        raise ValueError("non-finite linear-system data")    keypoint, _, rank, singular = np.linalg.lstsq(A, b, rcond=None)    if not np.isfinite(keypoint).all():        raise ValueError("non-finite solution")    if rank < 2:        raise ValueError("parallel voting lines: keypoint is not unique")    condition = singular[0] / singular[-1]    if condition > max_condition:        raise ValueError("ill-conditioned voting geometry")    residual = A @ keypoint - b    return keypoint, {        "rank": int(rank),        "condition": float(condition),        "rms_distance": float(np.sqrt(np.mean(residual ** 2))),    }
points = np.array([[100., 100.], [500., 100.],                   [100., 400.], [500., 400.]])expected = np.array([320., 240.])directions = expected - pointskeypoint, diagnostics = refine_keypoint(points, directions)assert np.allclose(keypoint, expected, atol=1e-9)print(keypoint, diagnostics)
max_condition=1e8 是这个 float64 教学基准的示例门限,不是网络精度或像素误差的保证。应依据允许误差、输入噪声和实际数值精度设置条件数、内点数量及残差门限。这里的残差是归一化法向量下的点到直线距离;它小也不保证关键点准确,因为近乎平行的线可能在很远处相交。
lstsq 返回的 residuals 在某些形状或秩不足时是空数组,所以例子主动计算残差。秩不足时,库仍可能给出一个最小范数解;这不等于数据已经唯一确定二维关键点,本例明确拒绝这种情况。NumPy lstsq
5. 在真实移植中逐层比较
跳转到“5. 在真实移植中逐层比较”- 固定一张输入图、一份权重和随机种子,保存模型提交、TensorRT/CUDA/PyTorch 版本、输入尺寸与精度模式。
- 比较原框架和引擎的 mask 及向量场,确认通道顺序、
(x,y)与(row,column)、缩放/裁剪/填充逆变换。mask 正常不能证明向量头正确。 - 保存同一关键点的
points、directions、内点索引、原始A,b和求解结果。检查有限值、方向长度和批次维度,不能在 reshape/transpose 时混淆关键点。 - 用相同内点分别比较 float64 CPU 参考与生产求解路径,记录秩、最小奇异值、条件数、残差和关键点误差。再逐项比较 FP32/FP16,避免同时更改数据和求解器。
- 若几何退化,返回明确的失败/置信状态,并按应用规则保留 RANSAC 候选或跳过位姿更新;不要静默用零点或单位矩阵假装求解成功。关键点允许落在图像外时,也不能简单裁剪坐标掩盖问题。
- 关键点恢复后,继续检查相机内参、图像缩放和 PnP 的 2D/3D 点对应关系,用重投影误差确认位姿。
本页补充验证运行于 NumPy 1.26.4:良态四条投票线恢复 (320,240);退化平行线、近乎平行线和非法输入被拒绝;同一良态问题的 QR 与正规方程求解相符;另外的人工病态矩阵展示了 FP32 正规方程可能丢失秩。它们验证数学说明与参考代码,不代替原故障复现。