堆
堆就像是山岳峰峦,层叠起伏、形态各异。座座山峰高低错落,而最高的山峰总是最先映入眼帘。
「堆 heap」是一种满足特定条件的完全二叉树,主要可分为两种类型,如图所示。
- 「小顶堆 min heap」:任意节点的值 ≤ 其子节点的值。
- 「大顶堆 max heap」:任意节点的值 ≥ 其子节点的值。
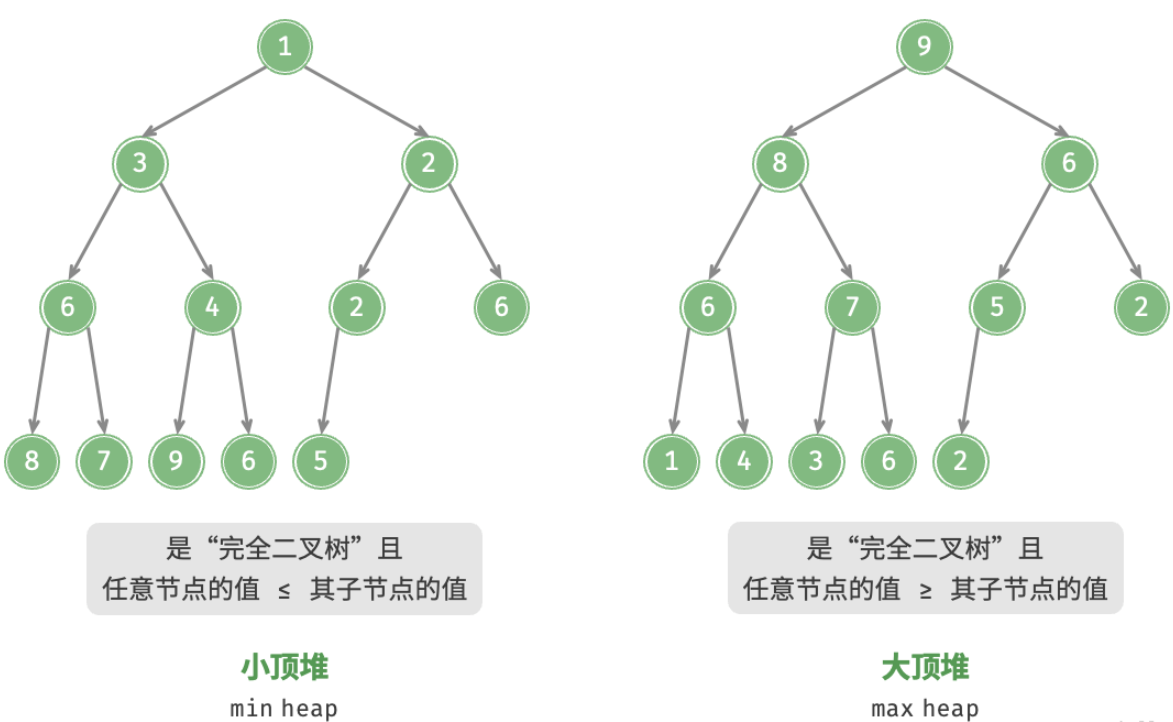
堆作为完全二叉树的一个特例,具有以下特性。
- 最底层节点靠左填充,其他层的节点都被填满。
- 我们将二叉树的根节点称为“堆顶”,将底层最靠右的节点称为“堆底”。
- 对于大顶堆(小顶堆),堆顶元素(根节点)的值是最大(最小)的。
许多编程语言提供的是「优先队列 priority queue」,这是一种抽象的数据结构,定义为具有优先级排序的队列。实际上,堆通常用于实现优先队列,大顶堆相当于元素按从大到小的顺序出队的优先队列。从使用角度来看,我们可以将“优先队列”和“堆”看作等价的数据结构。因此,本书对两者不做特别区分,统一称作“堆”。
| 方法名 | 描述 | 时间复杂度 |
|---|---|---|
push() | 元素入堆 | O(logn) |
pop() | 堆顶元素出堆 | O(logn) |
peek() | 访问堆顶元素(对于大 / 小顶堆分别为最大 / 小值) | O(1) |
size() | 获取堆的元素数量 | O(1) |
isEmpty() | 判断堆是否为空 | O(1) |
通过设置一个 flag 或修改 Comparator 实现“小顶堆”与“大顶堆”之间的转换。代码如下所示:
/* 初始化堆 */// 初始化小顶堆priority_queue<int, vector<int>, greater<int>> minHeap;// 初始化大顶堆priority_queue<int, vector<int>, less<int>> maxHeap;
/* 元素入堆 */maxHeap.push(1);maxHeap.push(3);maxHeap.push(2);maxHeap.push(5);maxHeap.push(4);
/* 获取堆顶元素 */int peek = maxHeap.top(); // 5
/* 堆顶元素出堆 */// 出堆元素会形成一个从大到小的序列maxHeap.pop(); // 5maxHeap.pop(); // 4maxHeap.pop(); // 3maxHeap.pop(); // 2maxHeap.pop(); // 1
/* 获取堆大小 */int size = maxHeap.size();
/* 判断堆是否为空 */bool isEmpty = maxHeap.empty();
/* 输入列表并建堆 */vector<int> input{1, 3, 2, 5, 4};priority_queue<int, vector<int>, greater<int>> minHeap(input.begin(), input.end());
堆的实现
跳转到“堆的实现”实现的是大顶堆。
堆的存储与表示
跳转到“堆的存储与表示”当使用数组表示二叉树时,元素代表节点值,索引代表节点在二叉树中的位置。节点指针通过索引映射公式来实现。
如图 8-2 所示,给定索引 i ,其左子节点的索引为 2i+1 ,右子节点的索引为 2i+2 ,父节点的索引为 (i−1)/2(向下整除)。当索引越界时,表示空节点或节点不存在。
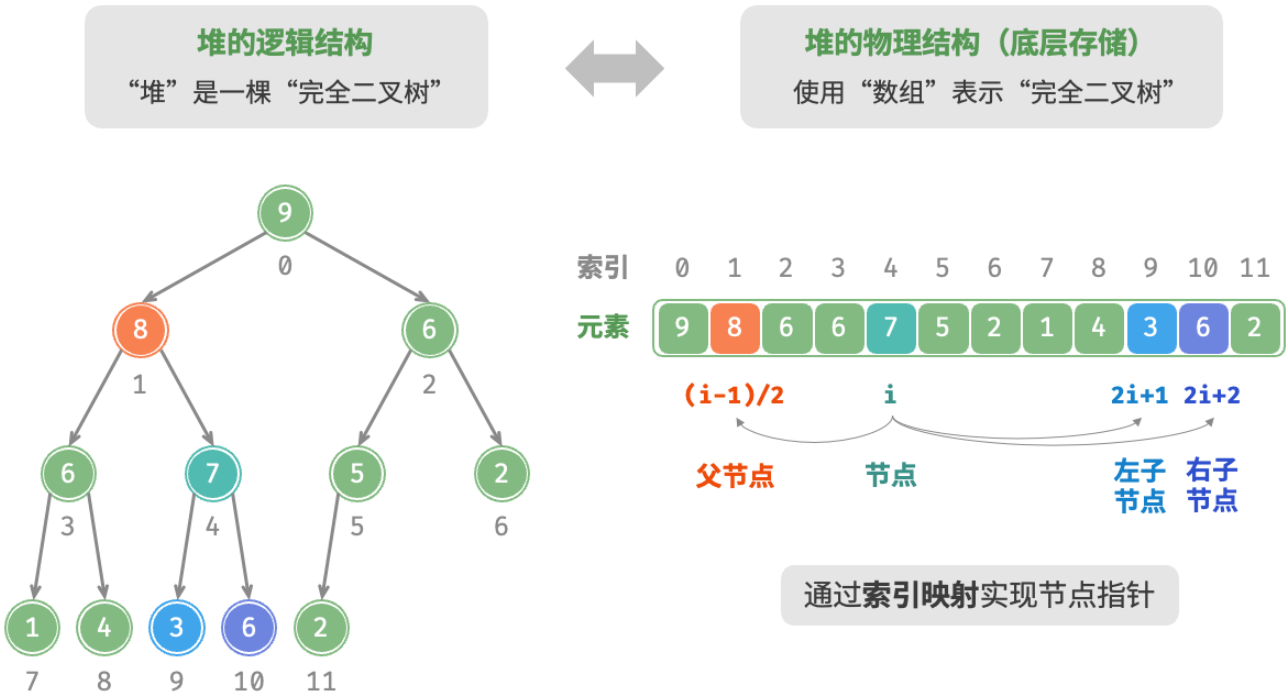
可以将索引映射公式封装成函数,方便后续使用:
/* 获取左子节点的索引 */int left(int i) {    return 2 * i + 1;}
/* 获取右子节点的索引 */int right(int i) {    return 2 * i + 2;}
/* 获取父节点的索引 */int parent(int i) {    return (i - 1) / 2; // 向下整除}
访问堆顶元素
跳转到“访问堆顶元素”堆顶元素即为二叉树的根节点,也就是列表的首个元素:
/* 访问堆顶元素 */int peek() { return maxHeap[0];}元素入堆
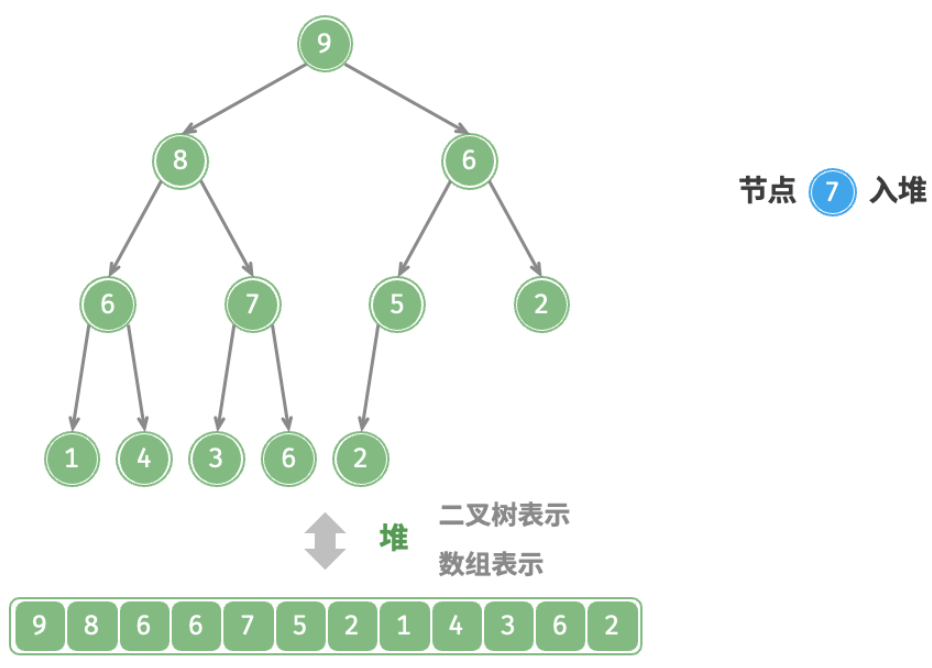
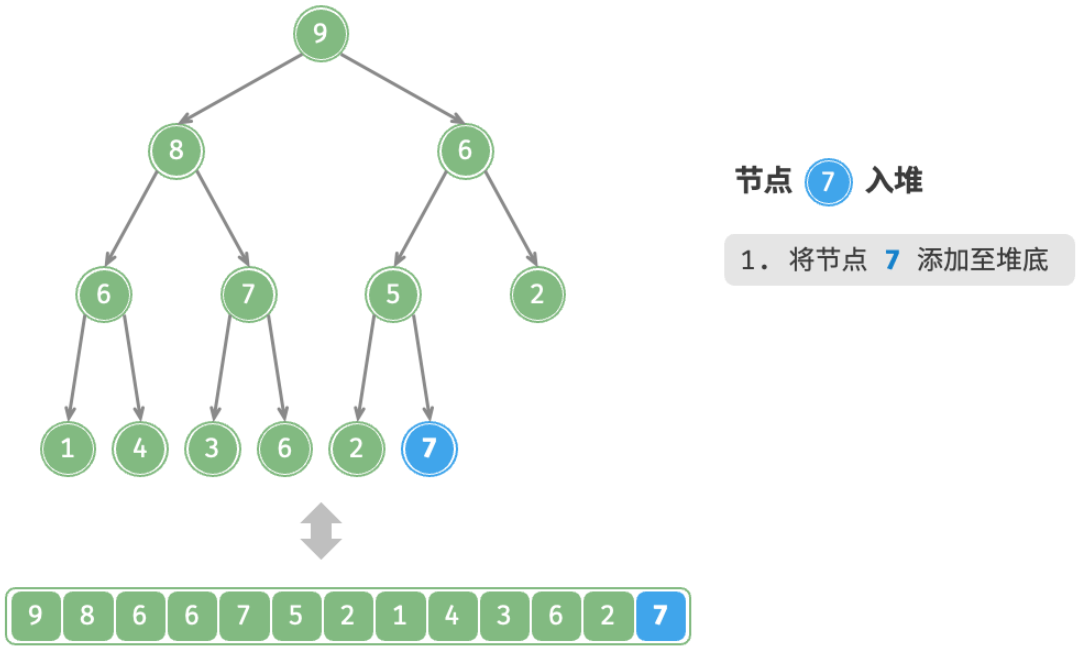
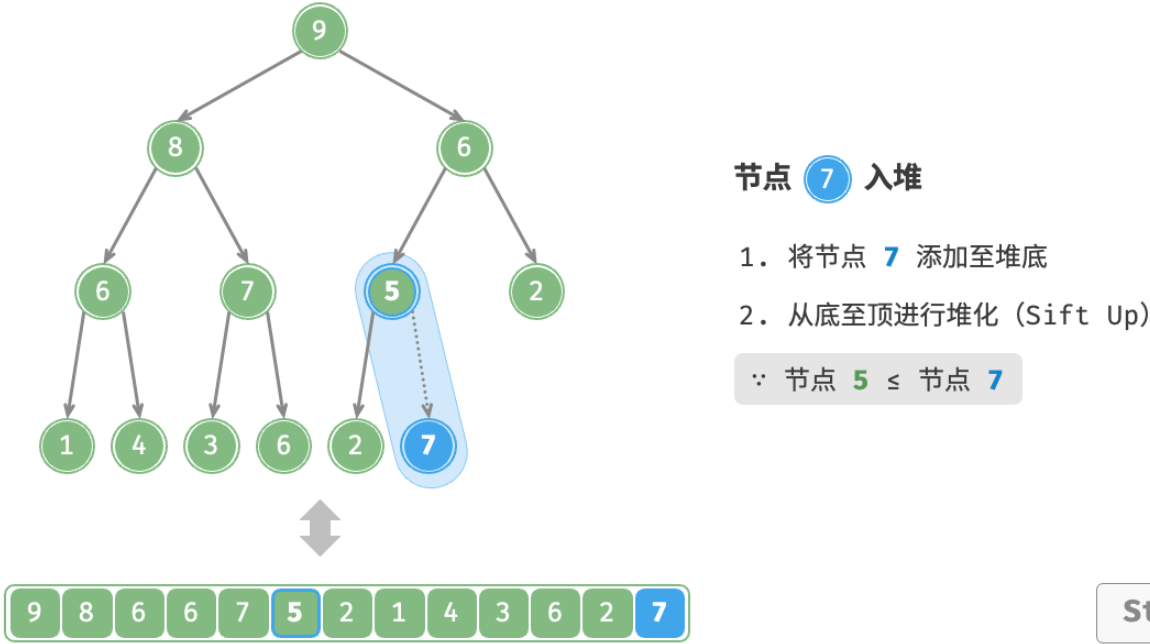
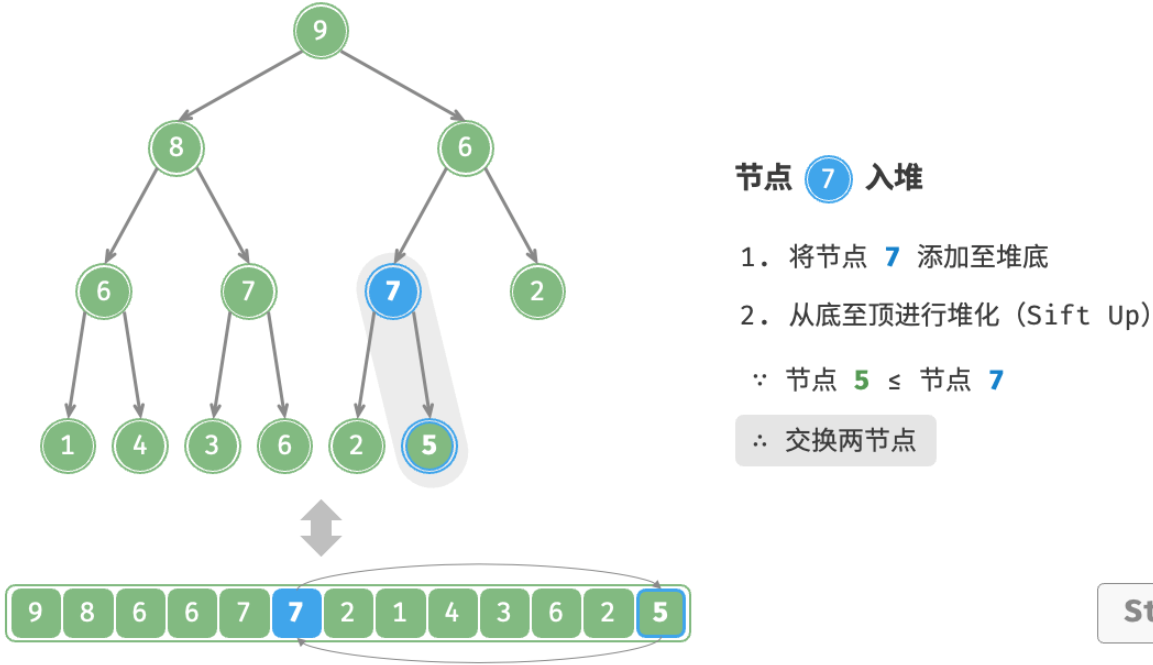
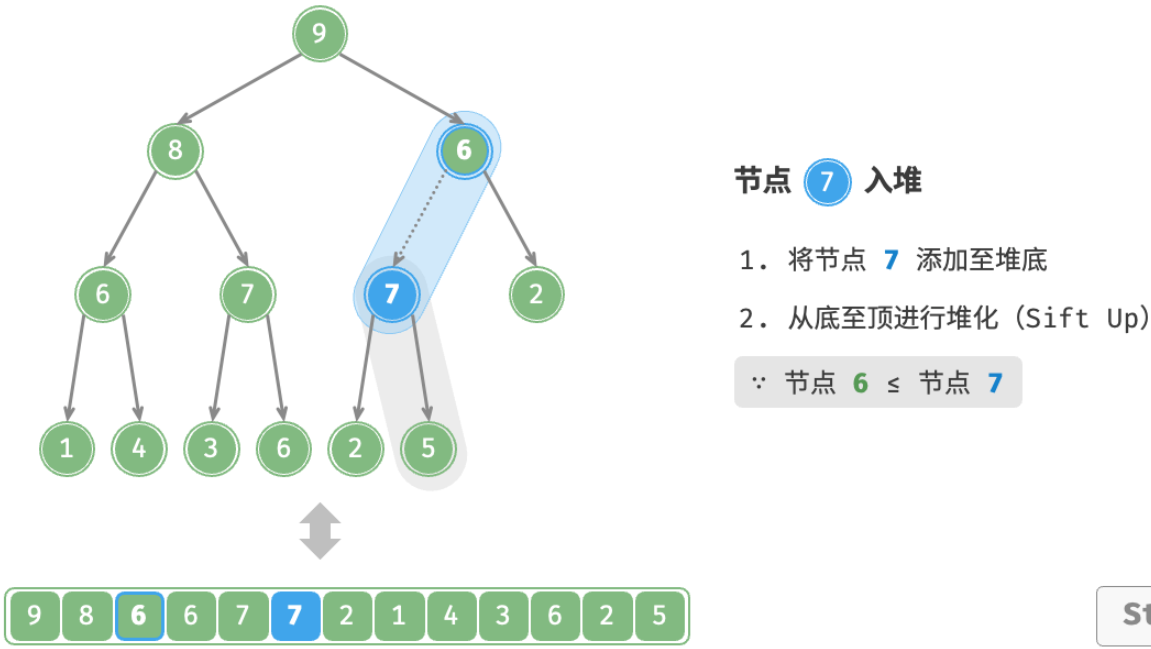
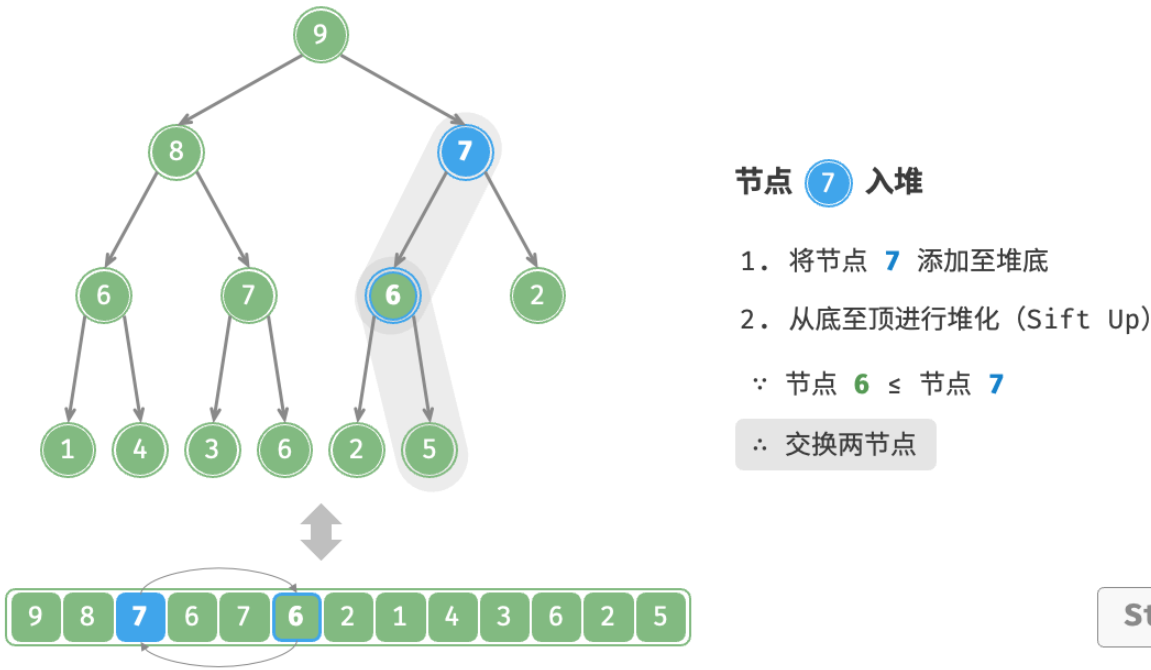
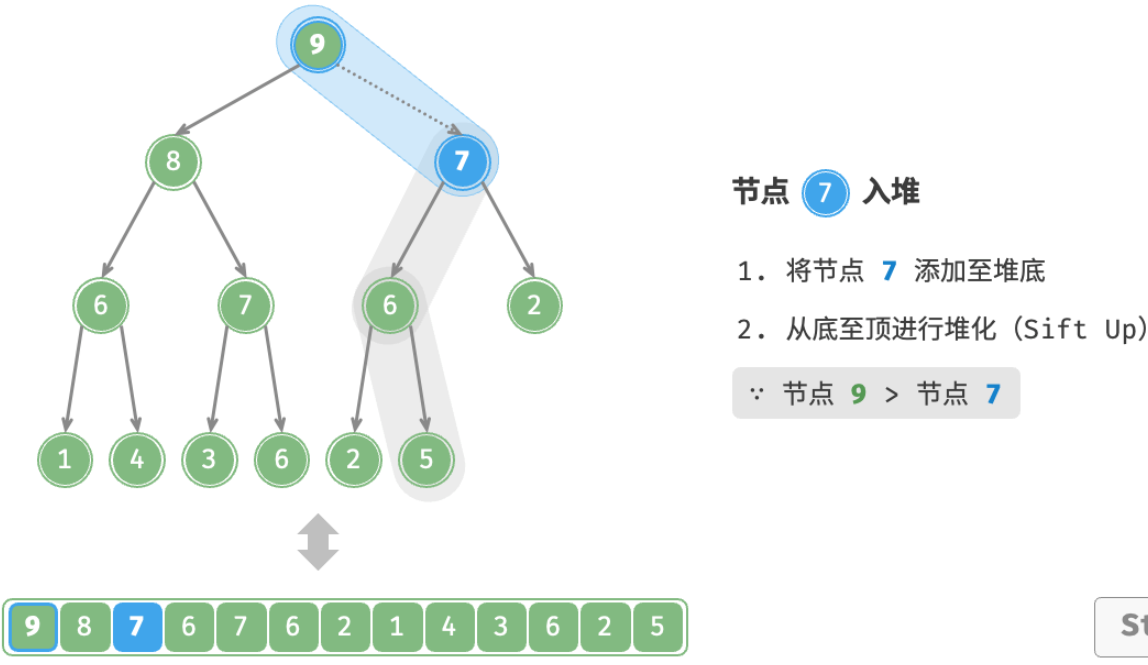
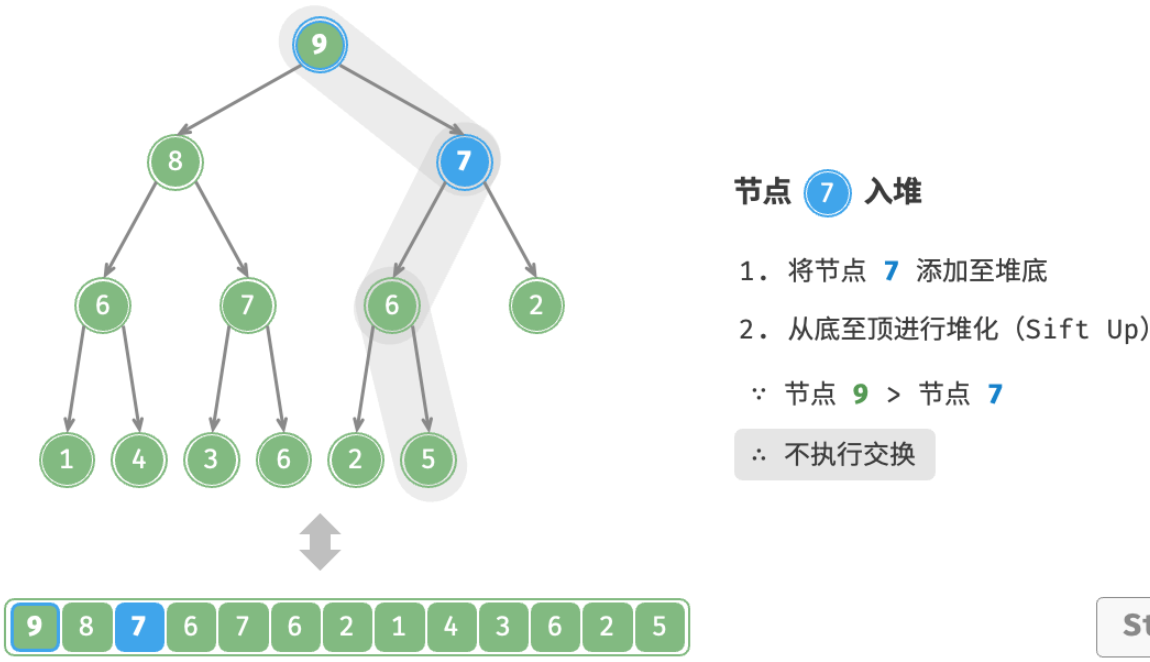
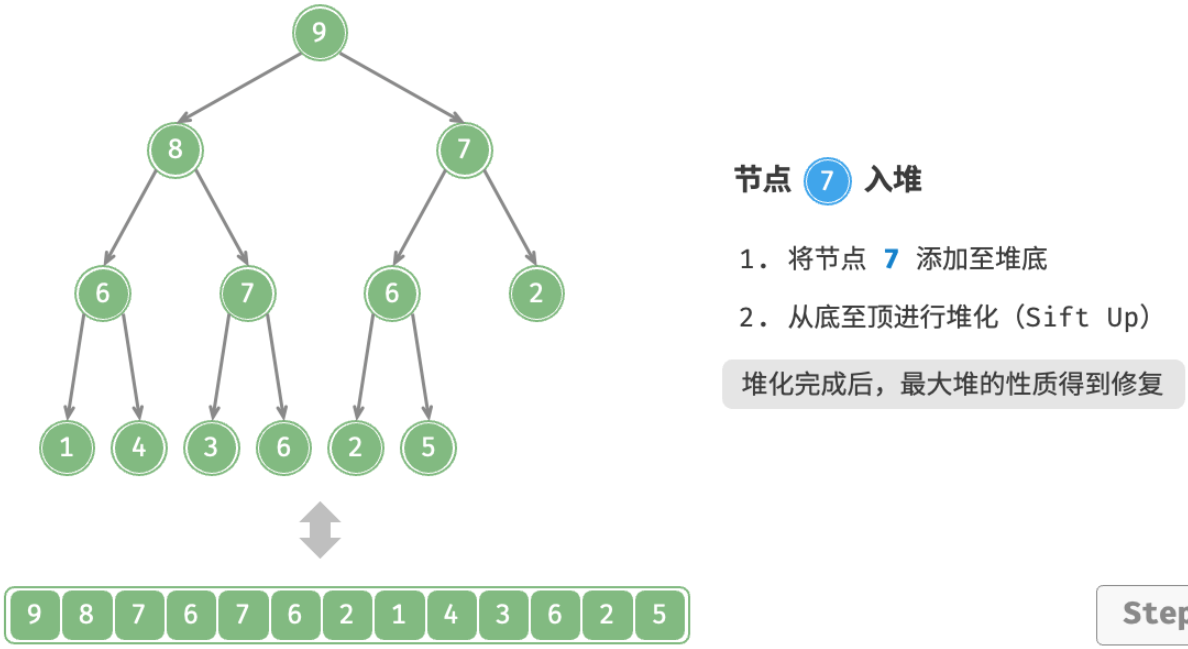
跳转到“元素入堆”给定元素 val ,我们首先将其添加到堆底。添加之后,由于 val 可能大于堆中其他元素,堆的成立条件可能已被破坏,因此需要修复从插入节点到根节点的路径上的各个节点,这个操作被称为「堆化 heapify」。
考虑从入堆节点开始,从底至顶执行堆化。如图所示,我们比较插入节点与其父节点的值,如果插入节点更大,则将它们交换。然后继续执行此操作,从底至顶修复堆中的各个节点,直至越过根节点或遇到无须交换的节点时结束。
| <1> | <2> | <3> |
|---|---|---|
 |  |  |
| <4> | <5> | <6> |
 |  |  |
| <7> | <8> | <9> |
 |  |  |
设节点总数为 n ,则树的高度为 O(logn) 。由此可知,堆化操作的循环轮数最多为 O(logn) ,元素入堆操作的时间复杂度为 O(logn) 。代码如下所示:
/* 元素入堆 */void push(int val) {    // 添加节点    maxHeap.push_back(val);    // 从底至顶堆化    siftUp(size() - 1);}
/* 从节点 i 开始,从底至顶堆化 */void siftUp(int i) {    while (true) {        // 获取节点 i 的父节点        int p = parent(i);        // 当“越过根节点”或“节点无须修复”时,结束堆化        if (p < 0 || maxHeap[i] <= maxHeap[p])            break;        // 交换两节点        swap(maxHeap[i], maxHeap[p]);        // 循环向上堆化        i = p;    }}
堆顶元素出堆
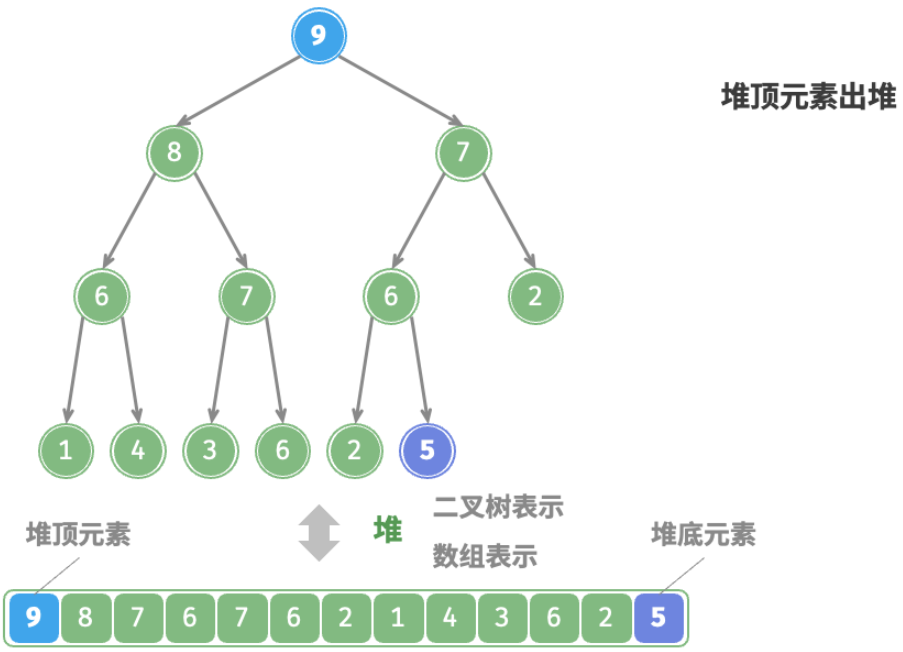
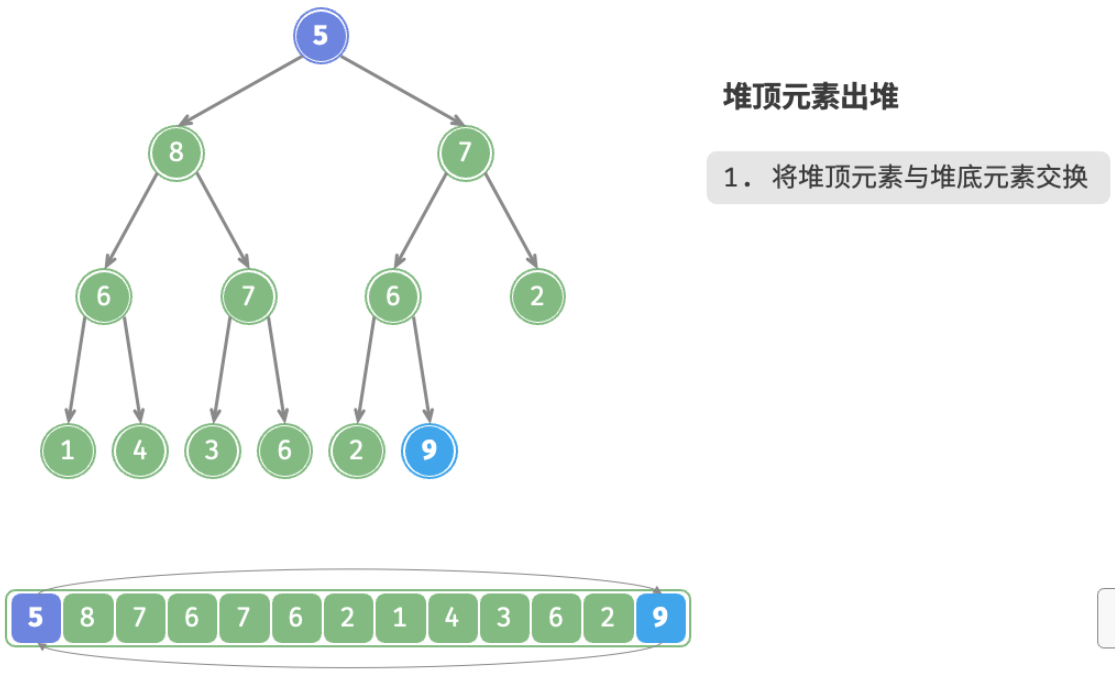
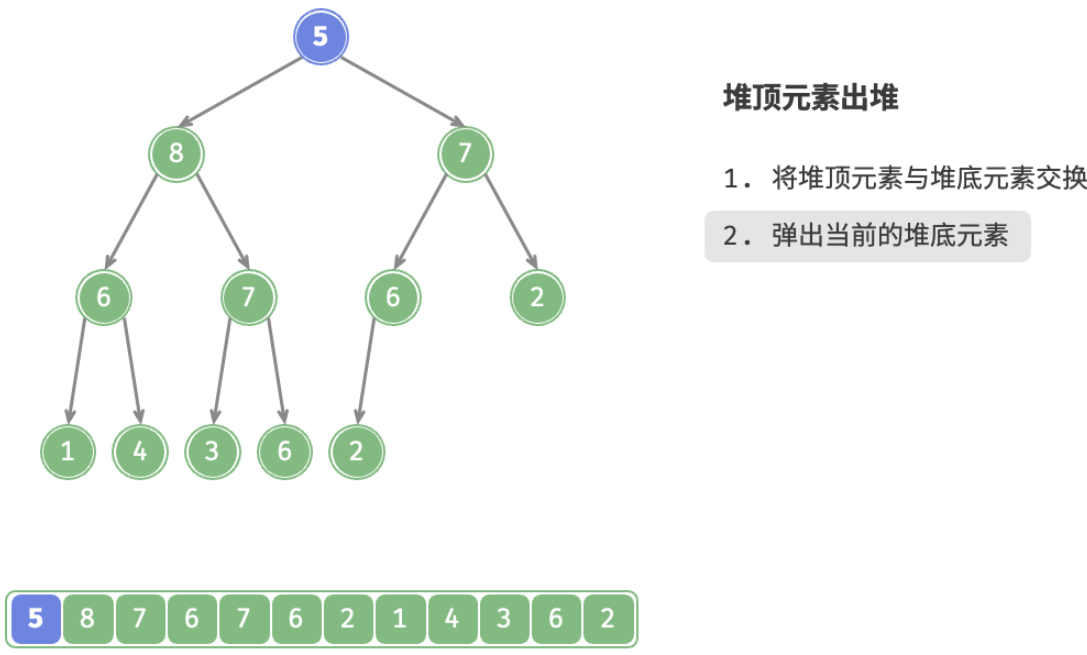
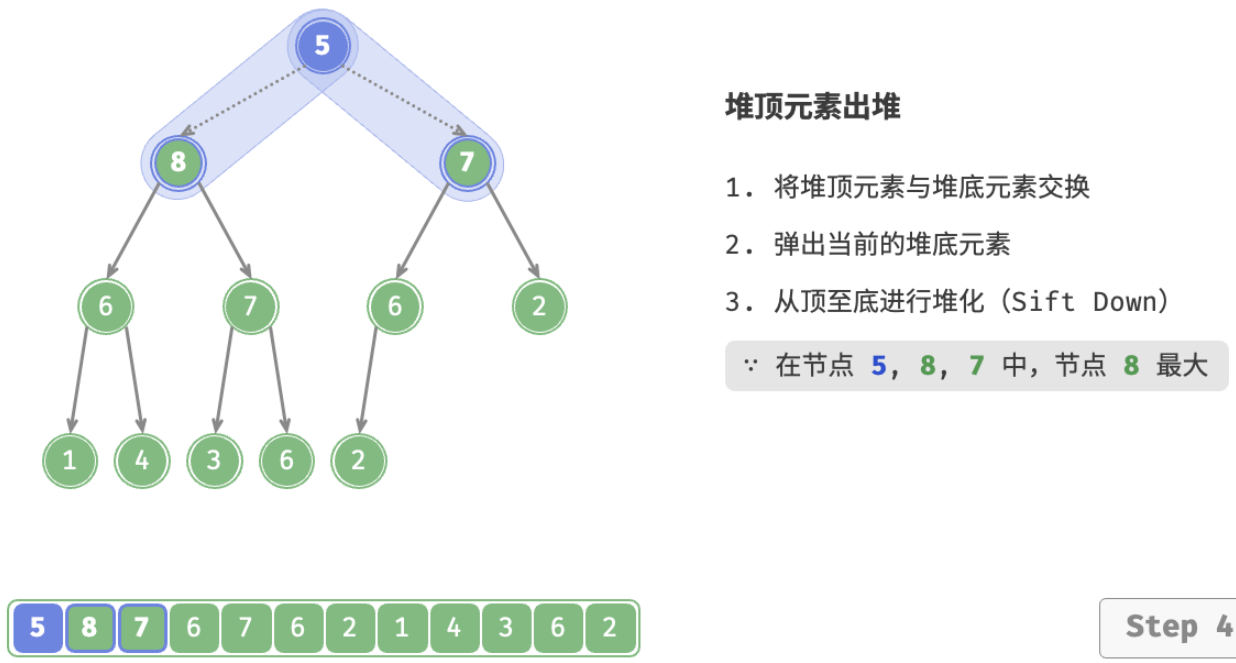
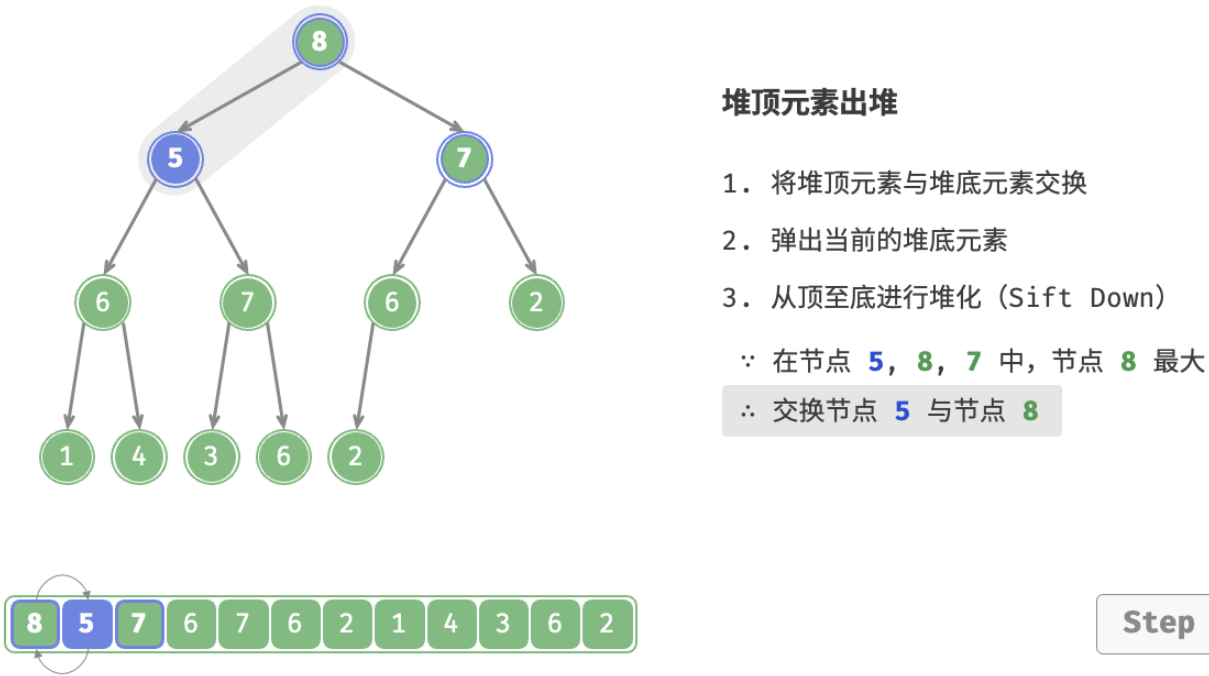
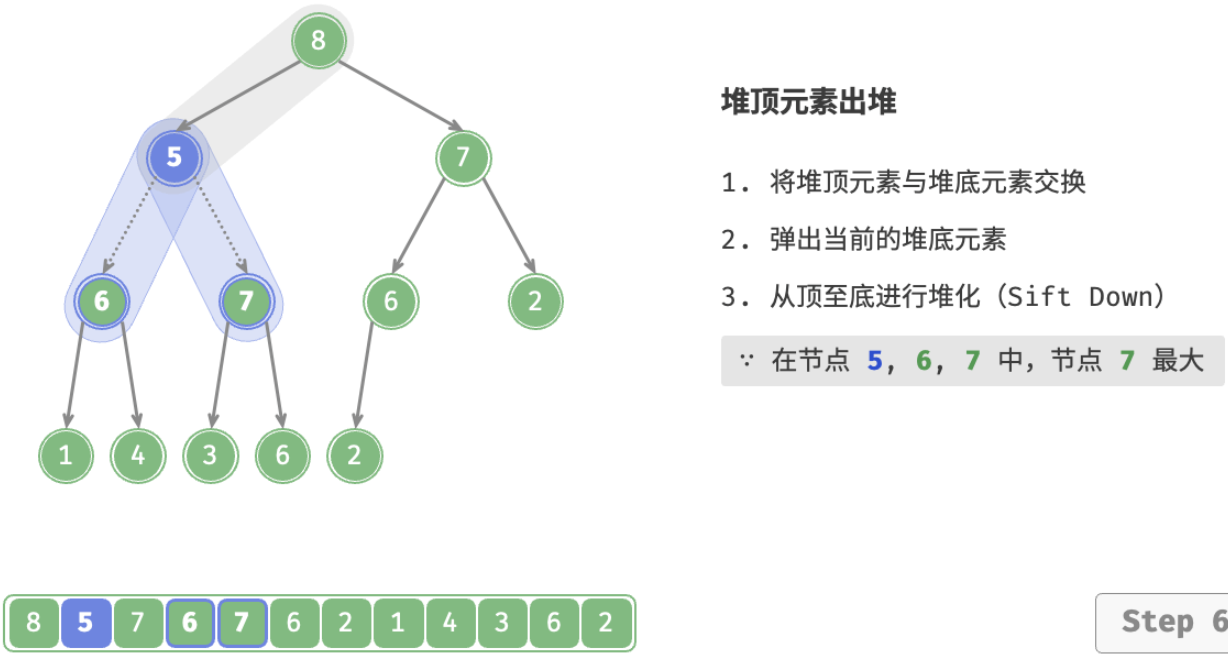
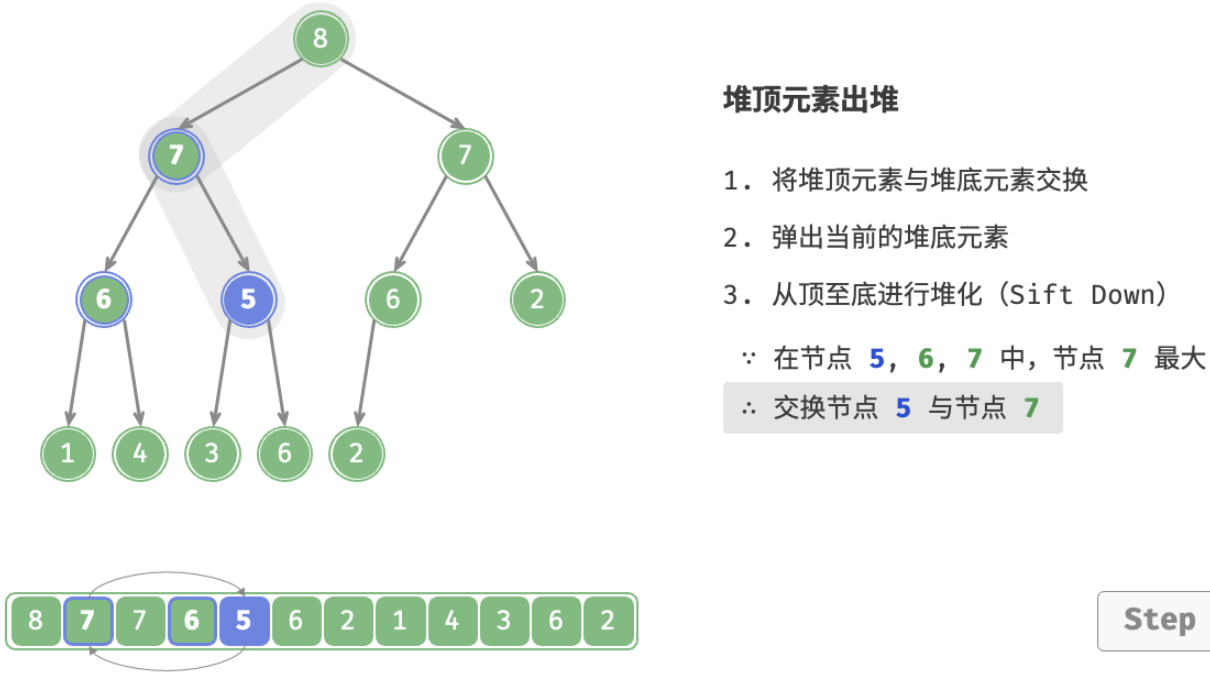
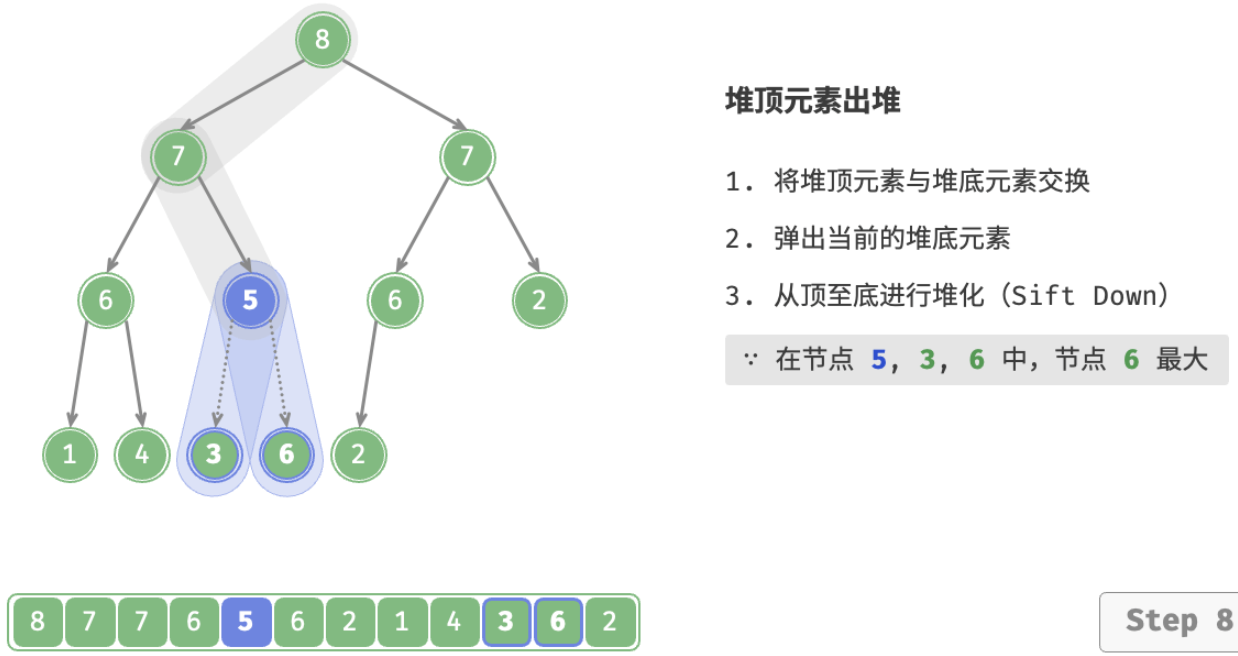
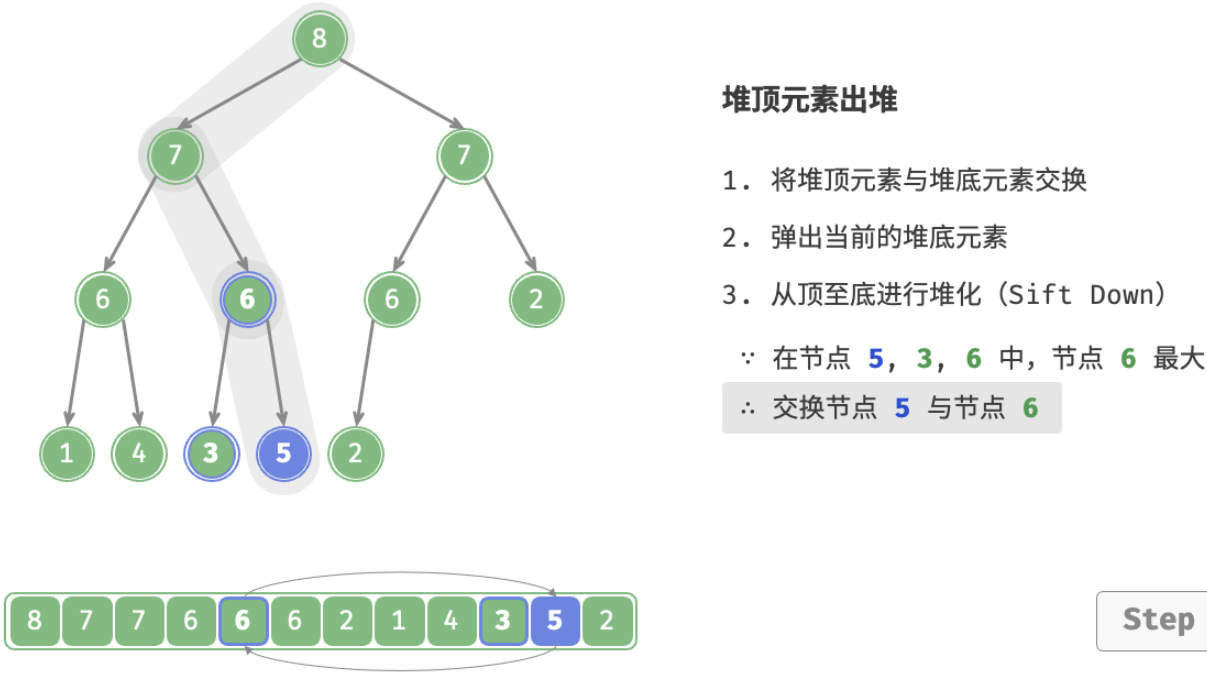
跳转到“堆顶元素出堆”堆顶元素是二叉树的根节点,即列表首元素。如果我们直接从列表中删除首元素,那么二叉树中所有节点的索引都会发生变化,这将使得后续使用堆化进行修复变得困难。为了尽量减少元素索引的变动,我们采用以下操作步骤。
- 交换堆顶元素与堆底元素(交换根节点与最右叶节点)。
- 交换完成后,将堆底从列表中删除(注意,由于已经交换,因此实际上删除的是原来的堆顶元素)。
- 从根节点开始,从顶至底执行堆化。
如图 所示,“从顶至底堆化”的操作方向与“从底至顶堆化”相反,我们将根节点的值与其两个子节点的值进行比较,将最大的子节点与根节点交换。然后循环执行此操作,直到越过叶节点或遇到无须交换的节点时结束。
| <1> | <2> | <3> |
|---|---|---|
 |  |  |
| <4> | <5> | <6> |
 |  |  |
| <7> | <8> | <9> |
 |  |  |
与元素入堆操作相似,堆顶元素出堆操作的时间复杂度也为 O(logn) 。代码如下所示:
/* 元素出堆 */void pop() {    // 判空处理    if (isEmpty()) {        throw out_of_range("堆为空");    }    // 交换根节点与最右叶节点(交换首元素与尾元素)    swap(maxHeap[0], maxHeap[size() - 1]);    // 删除节点    maxHeap.pop_back();    // 从顶至底堆化    siftDown(0);}
/* 从节点 i 开始,从顶至底堆化 */void siftDown(int i) {    while (true) {        // 判断节点 i, l, r 中值最大的节点,记为 ma        int l = left(i), r = right(i), ma = i;        if (l < size() && maxHeap[l] > maxHeap[ma])            ma = l;        if (r < size() && maxHeap[r] > maxHeap[ma])            ma = r;        // 若节点 i 最大或索引 l, r 越界,则无须继续堆化,跳出        if (ma == i)            break;        swap(maxHeap[i], maxHeap[ma]);        // 循环向下堆化        i = ma;    }}
堆的常见应用
跳转到“堆的常见应用”- 优先队列:堆通常作为实现优先队列的首选数据结构,其入队和出队操作的时间复杂度均为 O(logn) ,而建队操作为 O(n) ,这些操作都非常高效。
- 堆排序:给定一组数据,我们可以用它们建立一个堆,然后不断地执行元素出堆操作,从而得到有序数据。然而,我们通常会使用一种更优雅的方式实现堆排序,详见“堆排序”章节。
- 获取最大的 k 个元素:这是一个经典的算法问题,同时也是一种典型应用,例如选择热度前 10 的新闻作为微博热搜,选取销量前 10 的商品等。
建堆操作
跳转到“建堆操作”在某些情况下,希望使用一个列表的所有元素来构建一个堆,这个过程被称为**“建堆操作”**。
借助入堆操作实现
跳转到“借助入堆操作实现”首先创建一个空堆,然后遍历列表,依次对每个元素执行“入堆操作”,即先将元素添加至堆的尾部,再对该元素执行“从底至顶”堆化。 每当一个元素入堆,堆的长度就加一。由于节点是从顶到底依次被添加进二叉树的,因此堆是“自上而下”构建的。 设元素数量为 n ,每个元素的入堆操作使用 O(logn) 时间,因此该建堆方法的时间复杂度为 O(nlogn) 。
通过遍历堆化实现
跳转到“通过遍历堆化实现”一种更为高效的建堆方法,共分为两步。
- 将列表所有元素原封不动地添加到堆中,此时堆的性质尚未得到满足。
- 倒序遍历堆(层序遍历的倒序),依次对每个非叶节点执行“从顶至底堆化”。
每当堆化一个节点后,以该节点为根节点的子树就形成一个合法的子堆。而由于是倒序遍历,因此堆是“自下而上”构建的。
之所以选择倒序遍历,是因为这样能够保证当前节点之下的子树已经是合法的子堆,这样堆化当前节点才是有效的。
由于叶节点没有子节点,因此它们天然就是合法的子堆,无须堆化。如以下代码所示,最后一个非叶节点是最后一个节点的父节点,我们从它开始倒序遍历并执行堆化:
/* 构造方法,根据输入列表建堆 */MaxHeap(vector<int> nums) { // 将列表元素原封不动添加进堆 maxHeap = nums; // 堆化除叶节点以外的其他所有节点 for (int i = parent(size() - 1); i >= 0; i--) { siftDown(i); }}复杂度分析
跳转到“复杂度分析”考虑到二叉树底层节点数量远多于顶层节点的性质,接下来我们来进行更为准确的计算。为了降低计算难度,假设给定一个节点数量为 n 、高度为 ℎ 的“完美二叉树”,该假设不会影响计算结果的正确性。
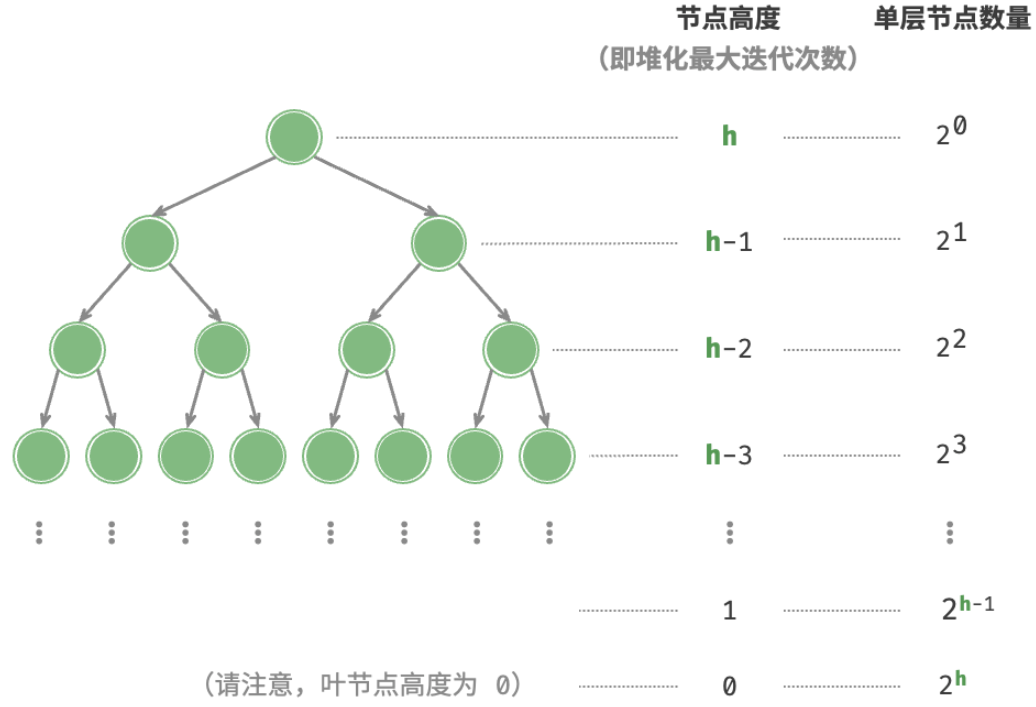
如图 8-5 所示,节点“从顶至底堆化”的最大迭代次数等于该节点到叶节点的距离,而该距离正是“节点高度”。因此,我们可以对各层的“节点数量 × 节点高度”求和,得到所有节点的堆化迭代次数的总和。
化简上式需要借助中学的数列知识,先将 O(ℎ) 乘以 2 ,得到:
使用错位相减法,用下式 2T(ℎ) 减去上式 T(ℎ) ,可得:
观察上式,发现 T(ℎ) 是一个等比数列,可直接使用求和公式,得到时间复杂度为:
进一步,高度为 ℎ 的完美二叉树的节点数量为 n=2ℎ+1−1 ,易得复杂度为 O(2ℎ)=O(n) 。以上推算表明,输入列表并建堆的时间复杂度为 O(n) ,非常高效。
Top-k 问题
跳转到“Top-k 问题”给定一个长度为 n 的无序数组
nums,请返回数组中最大的 k 个元素。先介绍两种思路比较直接的解法,再介绍效率更高的堆解法。
遍历选择
跳转到“遍历选择”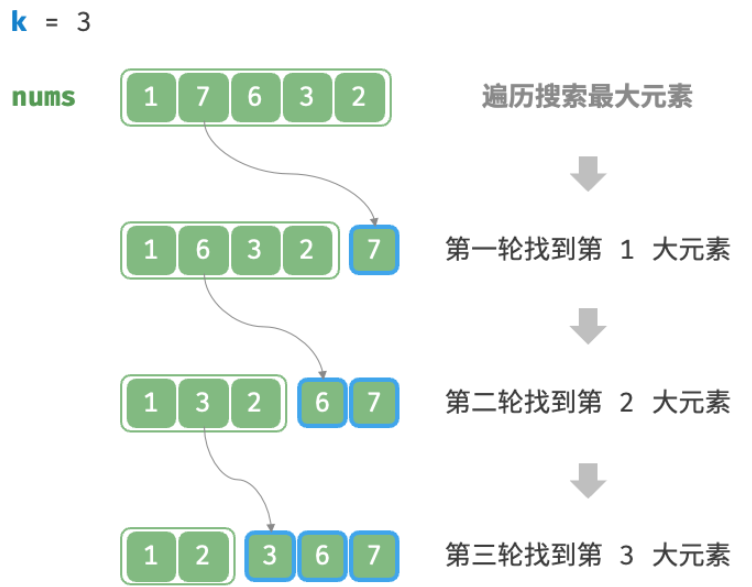
此方法只适用于 的情况,因为当 n 与 k 比较接近时,其时间复杂度趋向于 ,非常耗时。当 k=n 时,我们可以得到完整的有序序列,此时等价于“选择排序”算法。
排序
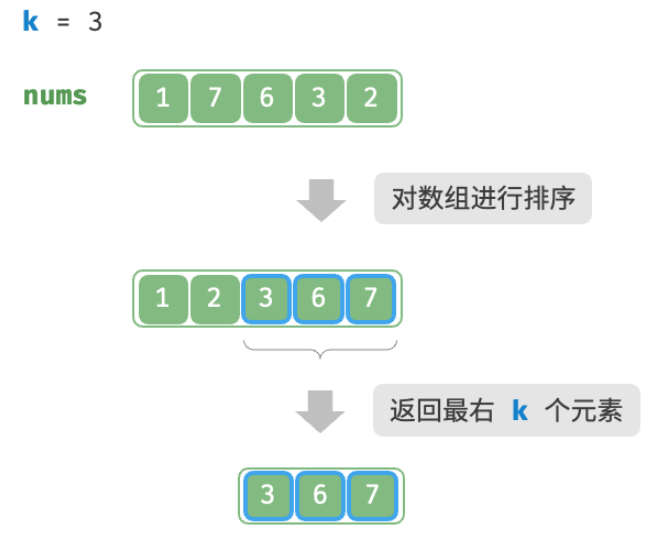
跳转到“排序”我们可以先对数组 nums 进行排序,再返回最右边的 k 个元素,时间复杂度为 O(nlogn) 。该方法“超额”完成任务了,因为我们只需找出最大的 k 个元素即可,而不需要排序其他元素。
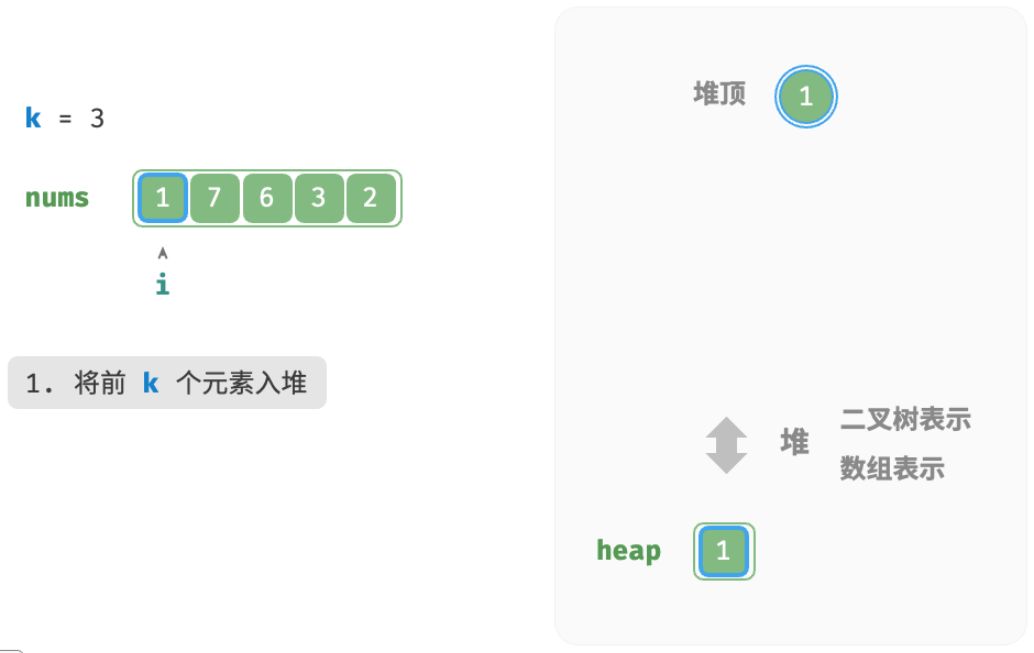
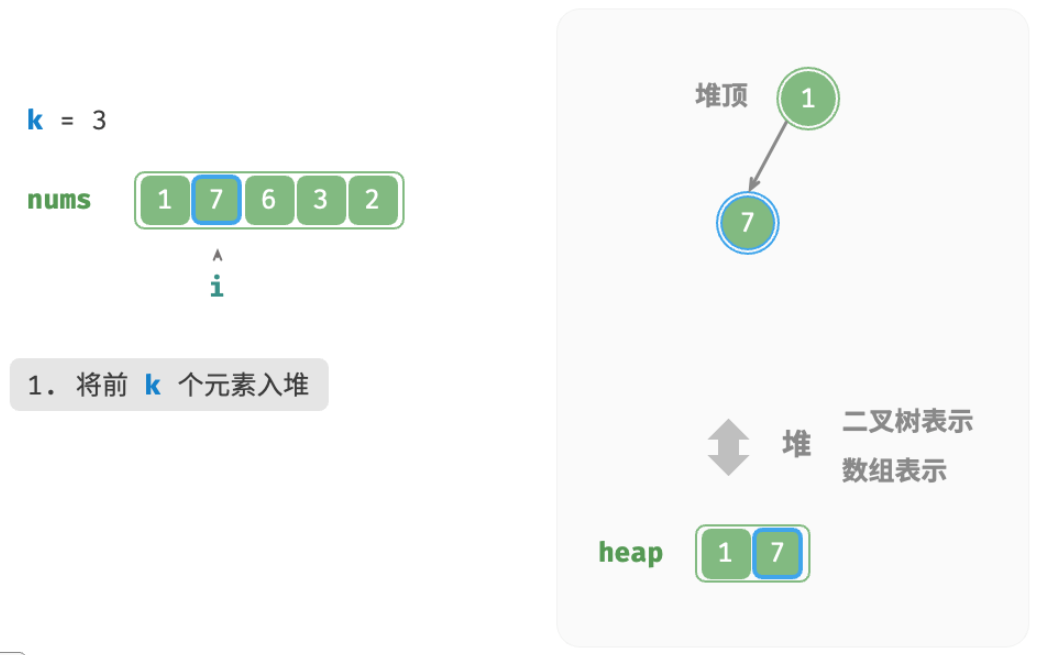
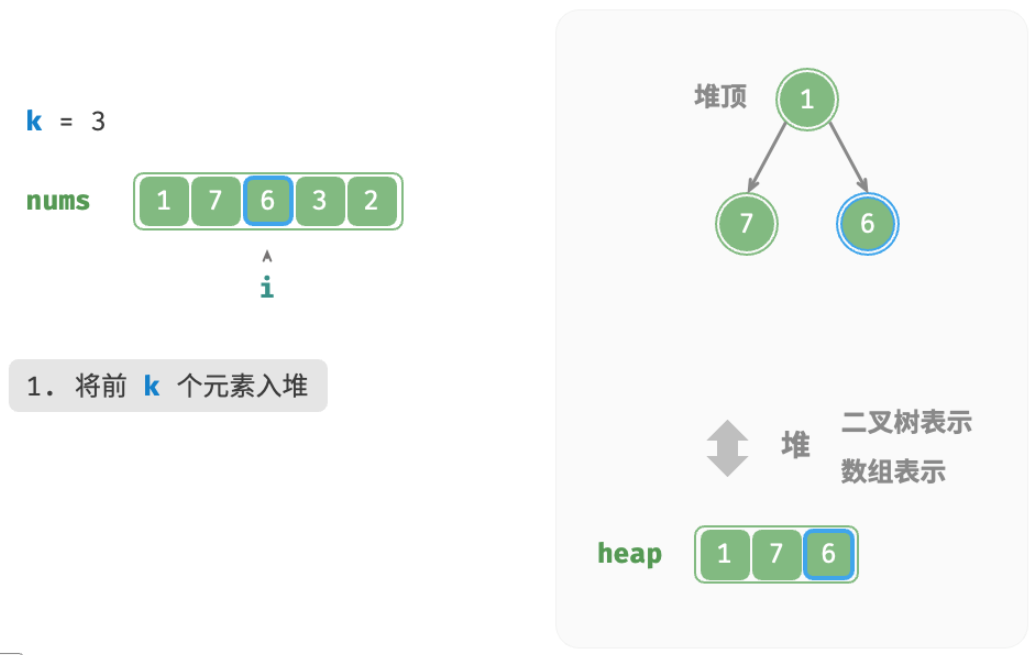
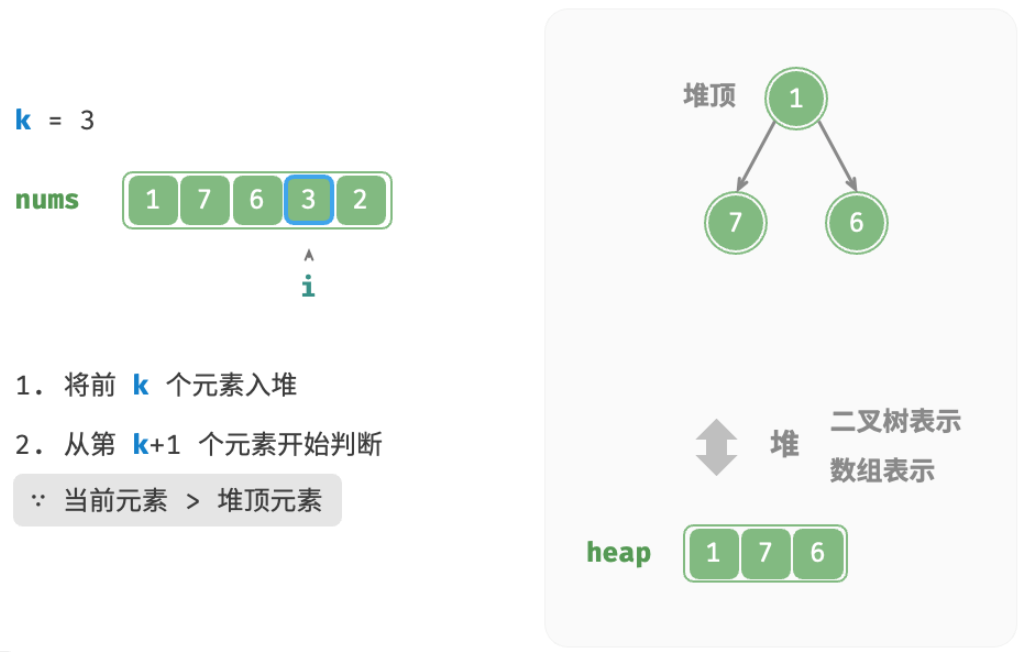
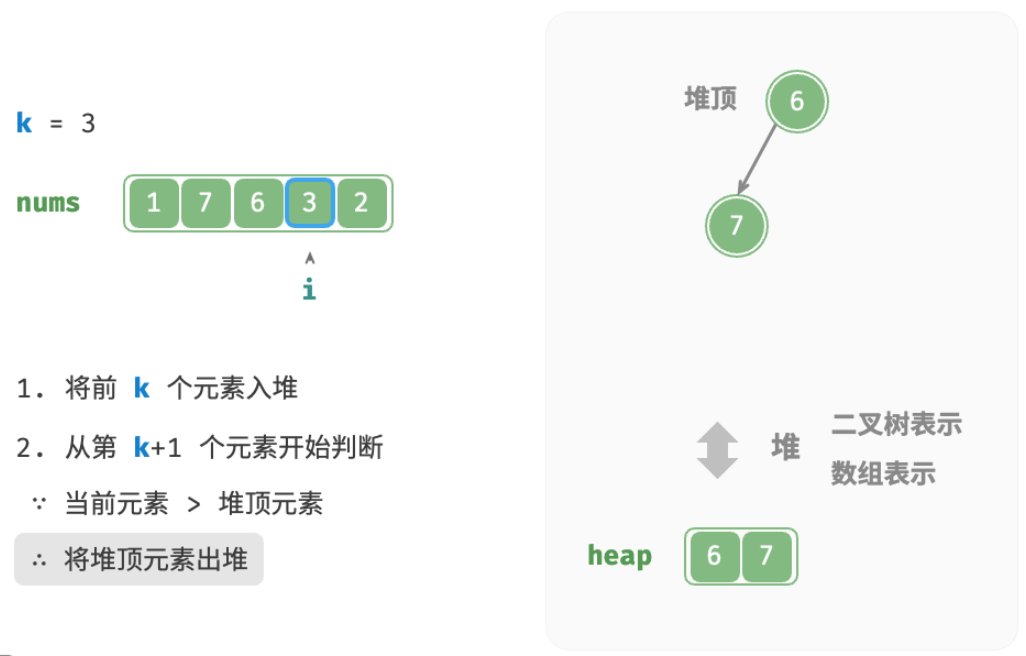
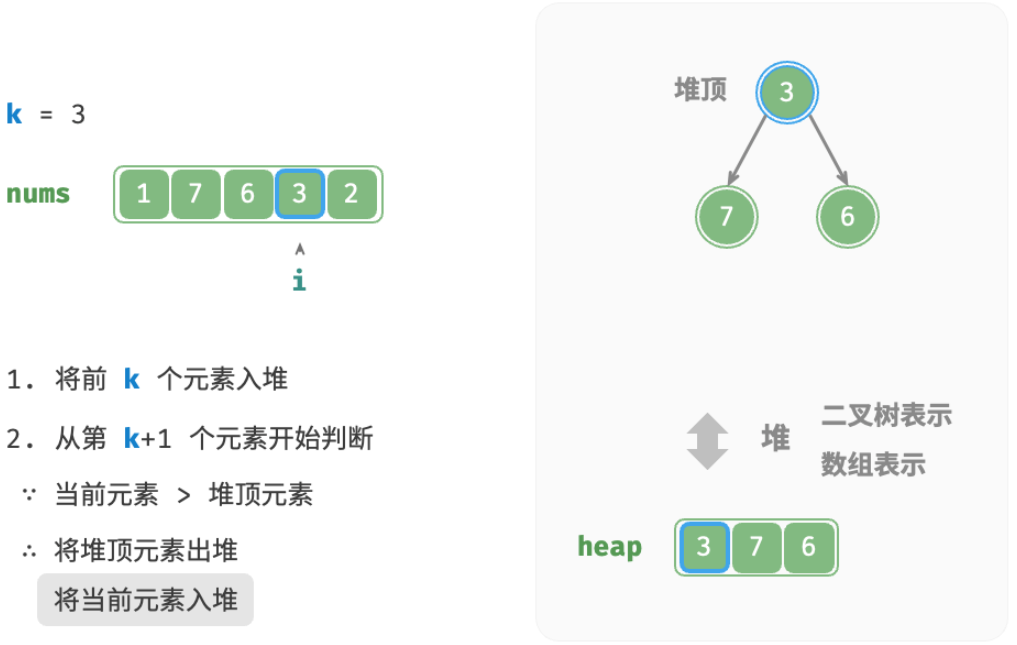
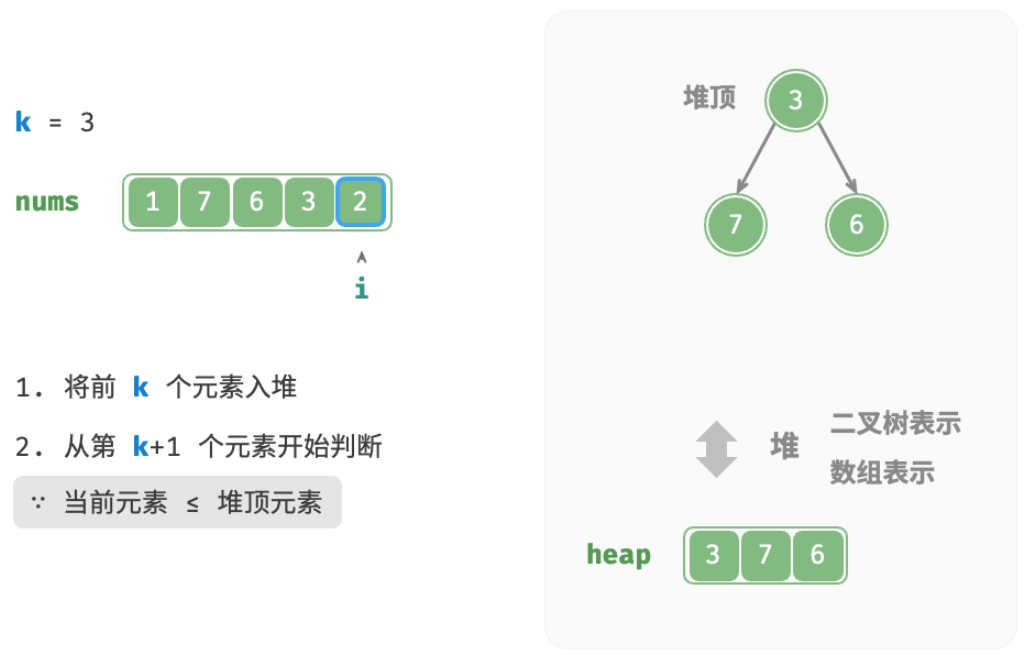
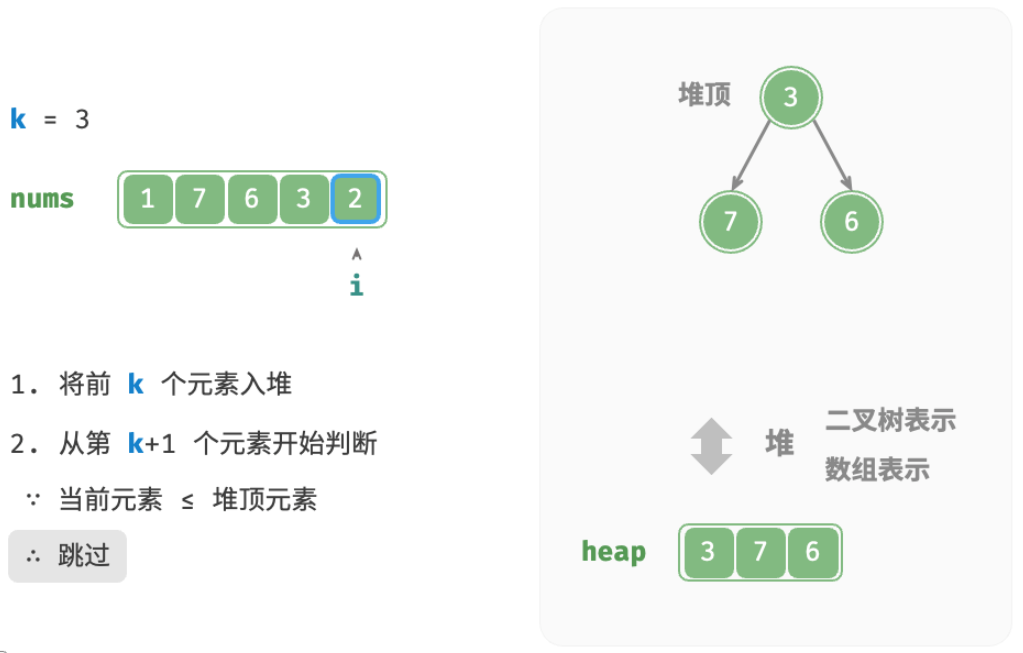
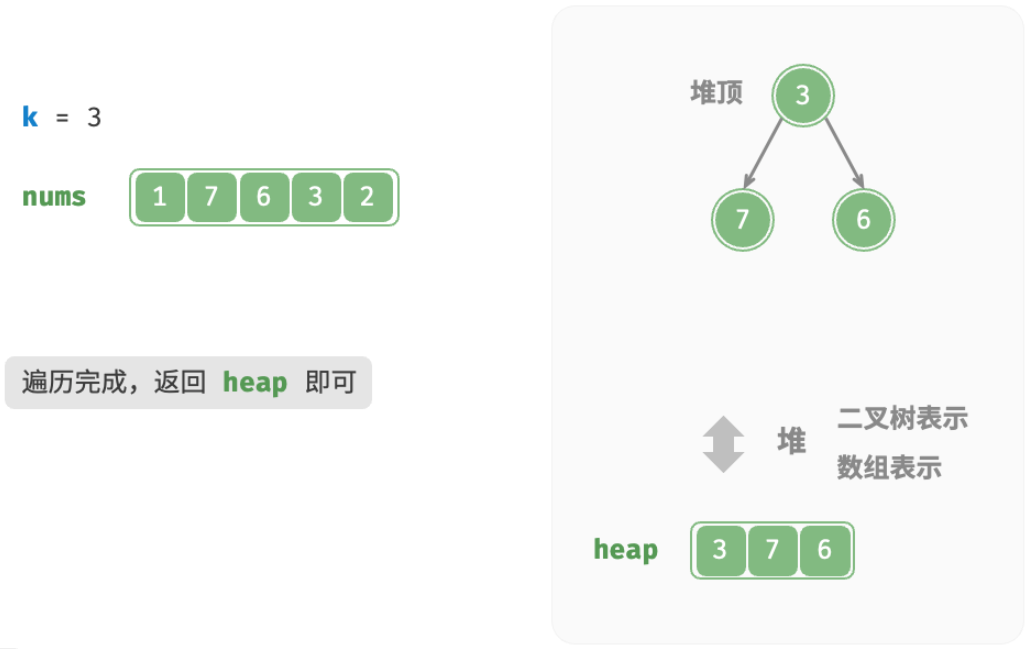
我们可以基于堆更加高效地解决 Top-k 问题,流程如图所示。
- 初始化一个小顶堆,其堆顶元素最小。
- 先将数组的前 k 个元素依次入堆。
- 从第 k+1 个元素开始,若当前元素大于堆顶元素,则将堆顶元素出堆,并将当前元素入堆。
- 遍历完成后,堆中保存的就是最大的 k 个元素。
| <1> | <2> | <3> |
|---|---|---|
 |  |  |
| <4> | <5> | <6> |
 |  |  |
| <7> | <8> | <9> |
 |  |  |
/* 基于堆查找数组中最大的 k 个元素 */priority_queue<int, vector<int>, greater<int>> topKHeap(vector<int> &nums, int k) { // 初始化小顶堆 priority_queue<int, vector<int>, greater<int>> heap; // 将数组的前 k 个元素入堆 for (int i = 0; i < k; i++) { heap.push(nums[i]); } // 从第 k+1 个元素开始,保持堆的长度为 k for (int i = k; i < nums.size(); i++) { // 若当前元素大于堆顶元素,则将堆顶元素出堆、当前元素入堆 if (nums[i] > heap.top()) { heap.pop(); heap.push(nums[i]); } } return heap;}总共执行了 n 轮入堆和出堆,堆的最大长度为 k ,因此时间复杂度为 O(nlogk) 。该方法的效率很高,当 k 较小时,时间复杂度趋向O(n);当 k 较大时,时间复杂度不会超过 O(nlogn) 。另外,该方法适用于动态数据流的使用场景。在不断加入数据时,我们可以持续维护堆内的元素,从而实现最大的 k 个元素的动态更新。