FFB6D:RGB-D 双向融合与三维关键点位姿估计
FFB6D 是 He 等人在 CVPR 2021 提出的 RGB-D 物体位姿估计方法。本页按“输入与坐标 → 特征融合 → 关键点预测 → 刚体拟合”重新组织原学习笔记,并把论文叙述与发布代码的具体约定分开。
目标是估计一个已知刚性物体相对于相机的旋转和平移。RGB 提供纹理与外观,深度提供几何;两者的误差和缺失模式不同。融合有机会让一条分支帮助另一条分支,但不能保证在所有遮挡、反光或深度失效情形下都能恢复正确姿态。
1. 先把坐标系和输入说清楚
跳转到“1. 先把坐标系和输入说清楚”设模型关键点为 ,它位于物体坐标系;同一关键点在相机坐标系中的位置为 。物体到相机的刚体变换为:
只有三个旋转自由度, 有三个平移自由度,因此称为 6D 位姿。这里没有引入世界坐标系。原笔记把模型点和相机点的坐标系写反,应以这个变换方向为准。
| 数据 | 作用 | 必须一致的约定 |
|---|---|---|
| RGB 与深度图 | 外观和观测几何 | 两幅图应正确对齐,深度无效值应处理 |
| 相机内参 | 像素与三维射线之间的关系 | 与图像尺寸、裁剪、缩放及去畸变状态一致 |
| 物体模型与固定关键点 | 提供物体系中的几何参照 | 长度单位、坐标原点、轴方向及关键点顺序一致 |
| 训练位姿 | 生成相机系关键点和偏移标签 | 明确是物体到相机,还是其逆变换 |
对于已校正畸变的针孔模型,内参为:
若深度 表示相机光轴方向的距离,则像素 的三维坐标是:
例如 像素、主点 、像素 、深度 2 m,对应 m。若传感器给的是沿射线的距离,不能未经转换就把它当成上述 。深度用 mm 而模型用 m,会让后面的位姿拟合整体错尺度。
2. 整体流程:先融合,再预测对应点
跳转到“2. 整体流程:先融合,再预测对应点”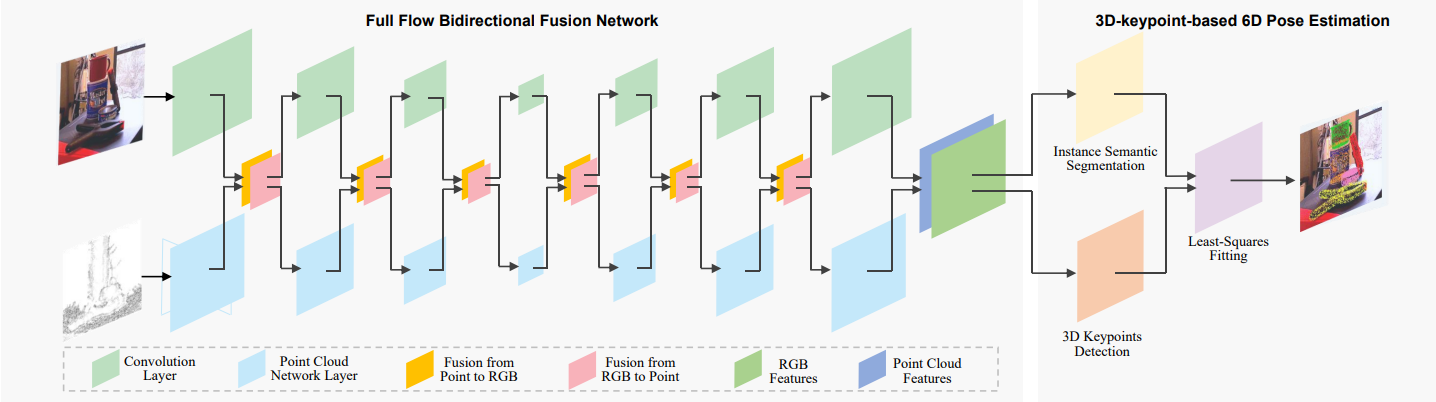
原论文流程图,保留自原笔记。图右侧的最小二乘拟合位于关键点预测之后;它与网络训练损失是不同层次的步骤。
可以把一次推理分成四段:
- 从对齐的深度图得到点云;图像分支提取外观,点云分支提取几何。
- 在多层编码和解码过程中,按三维位置关联两条分支,交换局部特征。
- 由最终逐点特征预测语义类别、物体中心偏移和关键点偏移,再聚合关键点投票。
- 将已知模型关键点与预测的相机系关键点对应起来,求解 。
“全流程双向融合”强调中间层也能交换信息,而不只是最后拼接两个独立网络的输出。它并不表示输入数据不需标定,也不表示两种模态之间所有位置都可直接一一对应。
3. 双向融合具体做什么
跳转到“3. 双向融合具体做什么”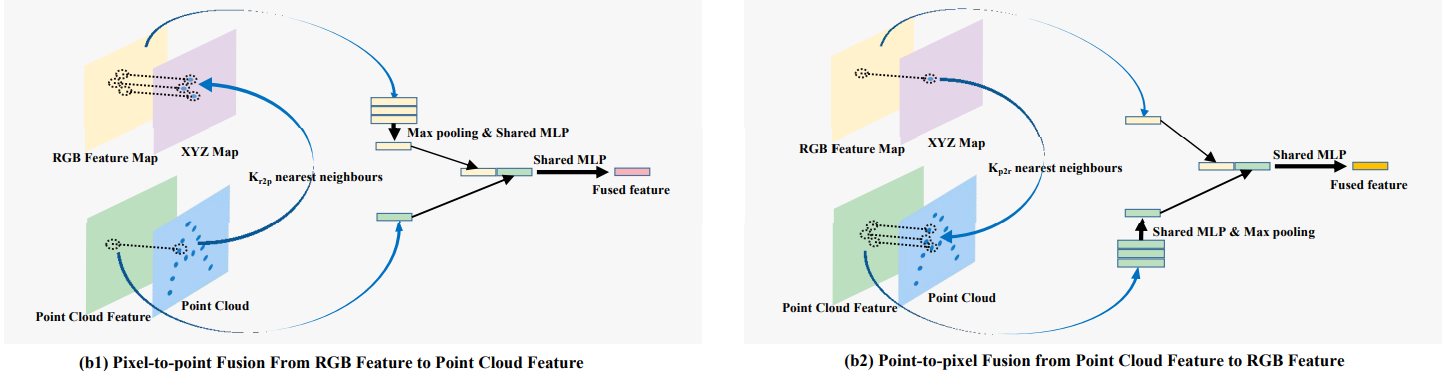
原论文融合图。左边是外观进入点云分支,右边是几何进入图像分支;两个方向的池化与 MLP 顺序并不相同。
3.1 像素特征到点特征
跳转到“3.1 像素特征到点特征”XYZ 图为图像特征位置提供三维参照。对某个点,在三维空间中选取对应图像位置的邻域 ,收集邻域外观特征 :
这里的最大值逐通道计算, 表示沿特征通道拼接,不是数值相加。MLP 将聚合后的外观信息映射到适合融合的通道数。
3.2 点特征到像素特征
跳转到“3.2 点特征到像素特征”反方向对图像特征对应的 XYZ 位置查找点云邻域 :
“先映射再池化”与“先池化再映射”一般不能任意交换,因为 MLP 会混合通道并可能包含非线性。论文的两个方向就采用了不同顺序。
图像分辨率改变时,XYZ 对应关系也要随层级处理。对前景与背景交界处直接平均深度,可能生成并不存在的中间空间位置,因此不能把普通颜色插值规则无条件用于几何对应。
发布代码的 YCB 数据加载器使用三维 KNN 构造关联:像素到点邻域为 16,点到像素为 1;这是所核对配置,不是双向融合的必然常数。网络末端还会按采样索引从图像特征中取出与点云对应的特征,再进行拼接。见数据加载器与网络实现。
4. 固定关键点、偏移预测与投票
跳转到“4. 固定关键点、偏移预测与投票”4.1 关键点是在模型上预先选定的
跳转到“4.1 关键点是在模型上预先选定的”纯 FPS(最远点采样)重视三维空间中的分散程度;被选到的点仍可能落在纹理不明显的区域。论文提出 SIFT-FPS:从模型的多视角渲染图中找纹理关键点,将其反投影并变换回物体系,再用 FPS 选出分散的固定三维关键点。这是构建模型关键点的离线步骤,不等于每次推理都在输入 RGB 图上运行一遍 SIFT。
公开仓库需要另外核对:本页检查的版本在 YCB 和 LineMOD 配置中启用 use_orbfps=True,并从 ORB-FPS 关键点文件加载坐标。论文的 SIFT-FPS 与这套发布数据不是可以混用的名字。更换关键点集合或顺序以后,已有权重所预测的偏移通道也必须与之匹配。见配置和关键点加载函数。
4.2 偏移的符号必须与标签一致
跳转到“4.2 偏移的符号必须与标签一致”发布代码对相机系观测点 和目标关键点 使用:
预测偏移为 ,则这个点投给第 个关键点的位置是:
这是带长度的三维偏移,不是单位方向向量。如果训练标签定义成反方向,推理就必须改用加法;两种约定都可自洽,但不能交叉使用。
语义标签帮助排除背景,中心投票帮助筛选同一物体附近的观测,再对关键点位置投票进行聚类。并不是把所有类别、所有观测点都直接平均。
论文描述了基于实例的流程,但所核对的公开 YCB 评估函数按语义类别循环,每个类别输出一个位姿。要支持同一帧中任意多个同类别实例,还需检查和扩展实例分组逻辑。见投票与位姿恢复。
5. 网络损失与位姿拟合目标分开理解
跳转到“5. 网络损失与位姿拟合目标分开理解”网络训练包含三个任务:语义分类、中心偏移回归、关键点偏移回归。概念上可记为:
语义分支使用 Focal Loss;两种偏移分支使用前景掩码下的 L1 误差。以单个偏移为例,L1 误差是三个坐标差绝对值的和:
实际训练还涉及前景点数归一化、批量归约和关键点求和。公开 YCB 训练代码将三项乘以 2、1、1,但这些权重与其归约方式配套,不能脱离实现直接照搬到另一种损失定义中。见训练代码与损失实现。
原笔记标题 “LOSS” 下只有最小二乘公式,容易让人误以为它就是完整网络训练目标。下面的 是关键点已经得到以后,用于恢复刚体位姿的几何目标。
6. 从对应关键点推导最小二乘刚体拟合
跳转到“6. 从对应关键点推导最小二乘刚体拟合”设模型与相机关键点一一对应,且统一使用列向量。求:
6.1 消去平移
跳转到“6.1 消去平移”先定义两个点集的均值:
固定 ,对 求导并令其为零:
令 、,代回目标:
其中 ,所以平方展开后只有交叉项与旋转有关。
6.2 用 SVD 求旋转,排除镜像
跳转到“6.2 用 SVD 求旋转,排除镜像”对 做奇异值分解:
定义:
最后恢复 。 的最后一项用于保证 ;忽略它可能得到镜像反射,反射不属于三维旋转。
至少三个非共线且对应正确的点可以约束刚体位姿;不必要求四个非共面的点。共线点无法约束绕该直线的转动。实际数据中的错误对应、几何近退化、物体对称性和离群投票还会影响可辨识性与稳定性,最小二乘本身不具备离群点鲁棒性。
7. 可运行的 CPU 几何例子
跳转到“7. 可运行的 CPU 几何例子”下面是独立的 NumPy 教学实现,不调用 FFB6D 网络。数组每行存一个点,因此列向量公式在代码中写为 model @ rotation.T + translation。
import numpy as np
def fit_object_to_camera(model_points, camera_points):    model = np.asarray(model_points, dtype=np.float64)    camera = np.asarray(camera_points, dtype=np.float64)    if (model.ndim != 2 or model.shape[1:] != (3,)            or camera.shape != model.shape or len(model) < 3):        raise ValueError("需要相同形状的 N×3 点集,且 N>=3")    if not np.isfinite(model).all() or not np.isfinite(camera).all():        raise ValueError("坐标必须有限")    center_m, center_c = model.mean(0), camera.mean(0)    a, b = model - center_m, camera - center_c    h = a.T @ b    if min(np.linalg.matrix_rank(a), np.linalg.matrix_rank(b),           np.linalg.matrix_rank(h)) < 2:        raise ValueError("点集或对应关系退化")    u, _, vt = np.linalg.svd(h)    d = np.eye(3)    d[2, 2] = 1.0 if np.linalg.det(vt.T @ u.T) >= 0 else -1.0    rotation = vt.T @ d @ u.T    translation = center_c - rotation @ center_m    return rotation, translation
model = np.array([[0, 0, 0], [0.1, 0, 0],                  [0, 0.2, 0], [0, 0, 0.3]])rotation_true = np.array([[0, -1, 0], [1, 0, 0], [0, 0, 1]])translation_true = np.array([0.3, -0.2, 2.0])camera = model @ rotation_true.T + translation_truerotation, translation = fit_object_to_camera(model, camera)
np.testing.assert_allclose(rotation, rotation_true, atol=1e-12)np.testing.assert_allclose(translation, translation_true, atol=1e-12)np.testing.assert_allclose(model @ rotation.T + translation,                           camera, atol=1e-12)np.testing.assert_allclose(np.linalg.det(rotation), 1.0, atol=1e-12)print(np.round(translation, 6))  # [ 0.3 -0.2  2. ]
秩判断用于拒绝明显退化输入,不能代替针对传感器噪声的条件数与误差分析。本例验证的是坐标约定和几何求解,不是模型准确率、抗遮挡性能或运行速度。
8. 复现时优先核对什么
跳转到“8. 复现时优先核对什么”按次序检查:数据集与模型单位 → 内参与 RGB-D 对齐 → 模型关键点集合和通道顺序 → 偏移符号 → 语义/实例筛选 → 刚体拟合方向 → 评价指标。ADD 与 ADD-S、对称物体处理、距离阈值和 AUC 统计不能混称同一个“准确率”。
本次实际运行了上面的 NumPy 例子,并验证随机刚体变换、平面点、反射与退化输入;未运行 FFB6D 的 GPU 训练或预训练推理。与另一种“局部点云特征回归旋转”的路线比较,可继续阅读 G2L-Net。
原论文:CVPR 2021 出版页、作者 arXiv 版本。代码核对固定于 ethnhe/FFB6D 的 e90baf73 提交,不将旧依赖配置当成现代环境的一键安装保证。
原笔记来源:CSDN 原文,首次发布于 2022-10-19。两张原图保留用于解释原方法,新增推导与数值例子为本页的学习补充。