CenDerNet:多视角中心、曲率热图与渲染位姿搜索
CenDerNet 面向反光、少纹理、相互遮挡的工业零件。它先把多个已标定视角的 RGB 图像转换为中心和几何边缘热图,再通过三角化与“渲染—比较”估计已知 CAD 物体的位姿。
它的启发在于:让神经网络输出容易检查的中间表示,然后用几何方法搜索位姿。中心预测给出搜索起点,曲率表示用于区分朝向与细化位置。
1. 输入条件与坐标关系
跳转到“1. 输入条件与坐标关系”输入包含多个视角的 RGB 图像、各相机的内参与外参,以及待定位物体的 CAD 模型。它不依赖深度传感器,但也不是仅凭一张未标定照片恢复任意物体。
设物体到世界坐标系的位姿为 ,世界到第 个相机的外参为 。采用列向量,有
各视角联合优化的是同一组世界坐标系中的物体位姿。如果每张图使用互相独立、未对齐的相机坐标,就无法共享一个候选场景。
| 阶段 | 得到什么 | 主要约束 |
|---|---|---|
| RGB 转热图 | 中心概率分布、视空间曲率表示 | 尽量弱化材质、光照与背景变化 |
| 中心转三维点 | 每个物体的三维中心候选 | 多视角射线应接近相交 |
| 渲染并比较 | 物体旋转与平移 | 候选 CAD 场景的几何边缘应符合各视角预测 |
2. 网络预测的是中心和视空间曲率
跳转到“2. 网络预测的是中心和视空间曲率”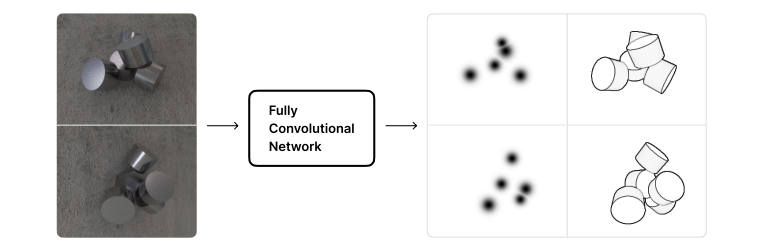
第一阶段:各视角使用同一套网络权重,输出中心热图和曲率热图。图中的黑白显示是可视化方式。
中心热图为什么使用高斯斑点
跳转到“中心热图为什么使用高斯斑点”中心热图以投影后的三维物体中心为目标,用高斯斑点表示邻域。它允许一定的位置误差,便于跨实例学习。斑点大小随物体尺寸和到相机的距离调整。
这一步刻意保留粗定位能力,而不要求网络直接输出高精度三维平移。较宽的斑点更容忍位置变化,但也更容易把相邻物体合并;“更平滑”并不总是更准确。
这里的曲率怎样生成
跳转到“这里的曲率怎样生成”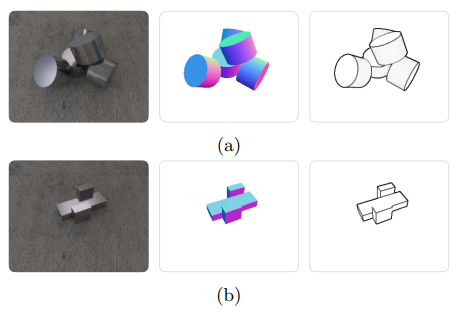
先渲染法线,再计算图像空间中的法线变化。平行平面相接时,法线相同的区域可能没有显著响应。
论文先渲染视空间法线图,再用 Prewitt 算子近似梯度,最后取梯度的二范数。若法线图为 ,便于理解的表达式为
它是图像网格上的法线变化表示,响应几何边缘和物体轮廓。它不等于微分几何中严格定义、与视点和成像分辨率无关的平均曲率或高斯曲率。背景法线的约定、遮挡关系和像素尺度都会影响边界响应。
这也解释了它为何能减弱颜色纹理的影响,同时仍有局限:同样的局部几何可能对应不同物体;大面积平坦区域提供的方向线索较少。
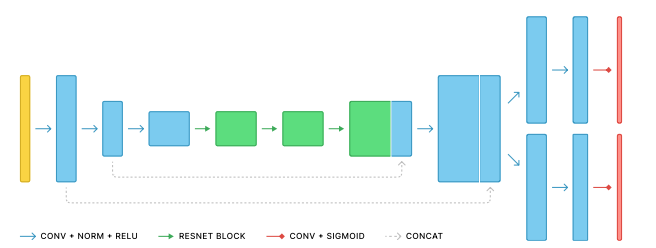
共享编码—解码主干后分别预测中心与曲率。末端的 sigmoid 输出适配热图监督。
论文对两个输出采用二元交叉熵。中心分支使用一个通道还是多个通道,取决于实验任务:DIMO 的设置共享中心通道;T-LESS 为区分 CAD 类别使用 30 个中心通道,曲率仍共享一个通道。因此不能把所有实验都描述为完全无类别的物体检测。
3. 从二维峰值到三维中心
跳转到“3. 从二维峰值到三维中心”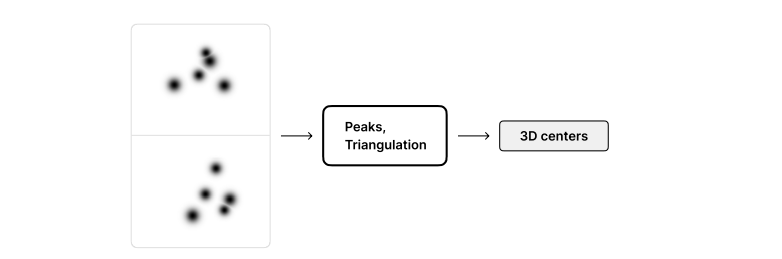
设第 个相机到世界的旋转和平移为 。一个热图峰值像素 对应世界中的射线
由于标定与预测都有误差,两条射线通常不精确相交。对两个视角,可求
再以两条射线上最近点的中点作为候选中心。若最近距离过大,候选应被拒绝;射线近乎平行时,深度也会十分不稳定。
论文随后合并距离接近的候选,并通过在多视角中心热图上的重投影得分优化三维位置。已知物体数量时还可以进一步筛选。
这不是无条件的点匹配:不同物体的峰值也可能形成一对“看似相交”的射线。多视角评分、空间范围约束及相邻候选抑制帮助排除伪中心,但不能保证恢复所有被遮挡物体。多个物体中心投影重合是论文展示的失败情形之一。
4. 渲染—比较的代价如何计算
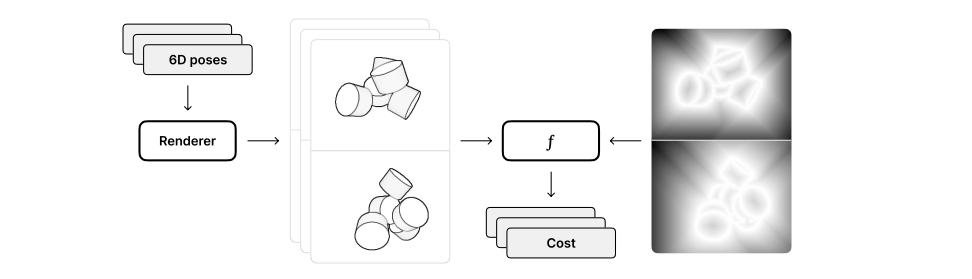
跳转到“4. 渲染—比较的代价如何计算”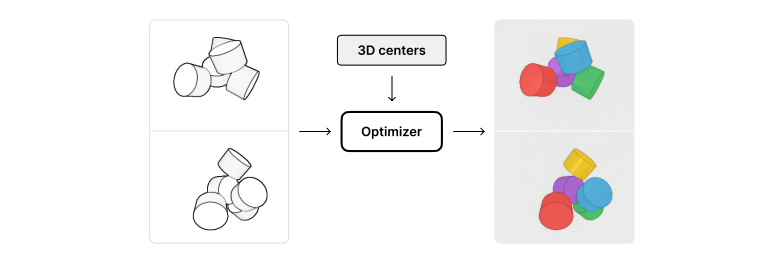
中心用于初始化和约束位姿搜索,曲率热图用于比较候选场景。
对网络预测的曲率热图使用阈值 ,得到二值边缘集合 。为每个像素预先计算到最近目标边缘的距离:
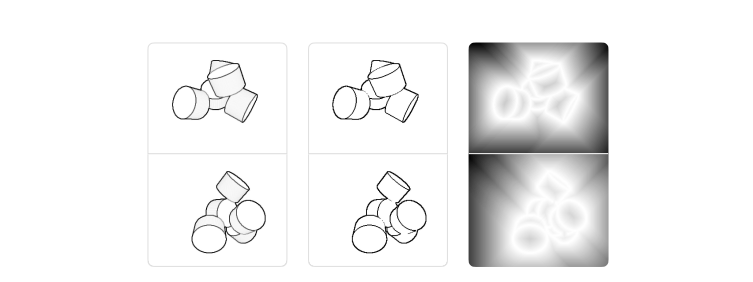
距离图只需由目标热图计算一次,可供大量候选位姿重复使用。显示中的明暗方向取决于可视化映射,不改变距离的定义。
设在候选场景位姿集合 下渲染出的非负曲率为 ,则单视角代价为
总成本为
渲染边缘越接近目标边缘,代价越低。按渲染曲率总量归一化,可以减少单纯增加响应数量带来的尺度差异。视角权重来自中心热图提供的可见性线索;它仍是估计,不是已知的真实遮挡比例。
这个代价有哪些盲点
跳转到“这个代价有哪些盲点”它是从渲染边缘到目标边缘的单向距离。目标中多出一些错误边缘,不一定增加当前候选的代价;错误边缘甚至可能成为更近的匹配。反过来,真实边缘缺失会让正确渲染受到惩罚。
如果目标边缘集合为空,“最近边缘”没有定义;如果渲染曲率总量为零,分母也无效。工程中应拒绝此类候选或采用明确的失败代价,不能只在分母加小数就让空渲染获得零损失。
对称物体的多个姿态可能渲染出相同图像,因此得到相同代价。这是观测中的不可辨识性;输出其中一个等价姿态不代表算法恢复了唯一真实角度。
5. 一个可运行的几何检查
跳转到“5. 一个可运行的几何检查”下面的示例独立实现两件事:两条射线的最近点中点,以及小尺寸二值边缘的距离图和单向渲染代价。暴力计算距离图只用于教学,实际大图应使用高效距离变换。
import numpy as np
def ray_midpoint(origin_a, direction_a, origin_b, direction_b):    values = [np.asarray(x, dtype=float) for x in              (origin_a, direction_a, origin_b, direction_b)]    if any(x.shape != (3,) or not np.isfinite(x).all() for x in values):        raise ValueError("each ray component must be a finite 3-vector")    oa, da, ob, db = values    norms = np.array([np.linalg.norm(da), np.linalg.norm(db)])    if np.any(norms <= 0):        raise ValueError("directions must be nonzero")    da, db = da / norms[0], db / norms[1]    a = np.column_stack([da, -db])    if np.linalg.svd(a, compute_uv=False)[-1] < 1e-6:        raise ValueError("nearly parallel rays")    distance, _, _, _ = np.linalg.lstsq(a, ob - oa, rcond=None)    if np.any(distance <= 0):        raise ValueError("closest points must be in front of both cameras")    pa, pb = oa + distance[0] * da, ob + distance[1] * db    return (pa + pb) / 2, np.linalg.norm(pa - pb)
def curvature_cost(render, target_edges):    c = np.asarray(render, dtype=float)    e = np.asarray(target_edges)    if c.ndim != 2 or c.shape != e.shape or c.size == 0:        raise ValueError("render and edges must have the same nonempty 2D shape")    if not np.isfinite(c).all() or np.any(c < 0) or c.sum() <= 0:        raise ValueError("render must have finite nonnegative positive total mass")    if e.dtype != np.bool_:        raise ValueError("target_edges must be a boolean mask")    target = np.argwhere(e)    if len(target) == 0:        raise ValueError("target contains no edges")    pixels = np.indices(c.shape).reshape(2, -1).T    distance = np.linalg.norm(pixels[:, None, :] - target[None, :, :], axis=2)    nearest = distance.min(axis=1).reshape(c.shape)    return float(np.sum(c * nearest) / c.sum())
center, gap = ray_midpoint([-1, 0, 0], [1, 0, 2],                           [1, 0, 0], [-1, 0, 2])np.testing.assert_allclose(center, [0, 0, 2], atol=1e-12)assert gap < 1e-12edges = np.zeros((5, 5), dtype=bool)edges[:, 2] = Truerender = np.zeros((5, 5))render[:, 3] = 1assert np.isclose(curvature_cost(render, edges), 1.0)assert np.isclose(curvature_cost(7 * render, edges), 1.0)
最后两个断言说明:当渲染边缘整体偏移一个像素时,代价为 1;只把所有渲染曲率乘以相同正数,不改变归一化代价。它们没有检验神经网络预测质量,也没有实现完整的多物体遮挡渲染。
6. 为什么按可见性顺序优化
跳转到“6. 为什么按可见性顺序优化”论文先优化更可见的物体,再把它们加入场景渲染,处理后方受到遮挡的物体。这使后续比较考虑已经定位物体造成的可见性变化。
每个物体先围绕三维中心生成候选平移,并随机采样旋转,再对较好的候选使用有界 Nelder–Mead 优化。论文设置首先评估 2000 个候选。
需要区分两层含义:
- 代价函数利用多个视角和场景中的多个物体。
- 搜索过程按物体顺序推进,并非每一步都同时对所有物体的全部参数做一个大规模联合优化。
早期中心错误、误选 CAD 类别或前方物体定位错误,可能继续影响后续搜索。增加候选数量只能缓解搜索覆盖不足,无法自动补救错误的成像标定或完全缺失的中间表示。
7. 怎样读实验结论
跳转到“7. 怎样读实验结论”原论文比较的是其特定数据、视角数和评价设置,不能把结果概括为“多视角方法总比单目方法好”或“超过所有 CosyPose 版本”。
| 原论文设置 | 可读出的结论 | 比较边界 |
|---|---|---|
| DIMO 反光物体子集 | 中心与曲率表示对该工业场景有帮助 | 论文使用多视角,对比的 PVNet 是单视角方法 |
| T-LESS 严格位姿阈值 | 对比所选 ECCV 2020 CosyPose 结果具有优势 | 本文 5 个视角与对方提供的 8 视角结果,设置并不相同 |
| T-LESS 默认 BOP 指标 | CenDerNet 的 AR 为 0.713;所选 CosyPose 为 0.617 | 论文同时列出的排行榜 CosyPose 版本 AR 为 0.839 |
MSSD 是考虑物体对称性的最大三维表面距离,MSPD 是相应的最大二维投影距离。严格设置使用物体直径的 5% 与 5 像素作为正确性阈值;它们与多阈值平均的默认 BOP AR 应分别解读。
论文给出的约 2000 次/秒,是 RTX 3090 Ti 上包含渲染的代价函数调用速度,每次处理六张 图像。它不等于完整系统每秒定位 2000 帧:热图预测、中心搜索、大量候选和局部优化均需另外计入。
网络训练与几何搜索也有不同成本。论文附录中,DIMO 使用 200 个 epoch、batch 8;T-LESS 使用 40 个 epoch、batch 4。两者分辨率、输出头与训练硬件均不同,不能只凭训练时长比较网络效率。
8. 实际值得借鉴的部分
跳转到“8. 实际值得借鉴的部分”这个框架适合用来研究“网络预测什么中间量更利于几何求解”。调试时可以直接检查中心峰值、三维射线交会、目标边缘、候选渲染和最终残差,逐步定位错误来源。
若目标是部署,还需要补齐相机外参稳定性、CAD 单位、遮挡渲染、空热图处理、候选采样和总延迟测试。这些都是完整系统的组成部分,不会由单次代价计算速度自动保证。
- 原论文及附录:De Roovere 等,CenDerNet: Center and Curvature Representations for Render-and-Compare 6D Pose Estimation,2022。
- NOCS 类别规范坐标:对比类别级表示与此处已知 CAD 的多视角定位。
- RGB 位姿与投影几何:补充内参、像素对应和位姿复合。
- CSDN 原笔记:首次发布于 2022-10-25。本篇保留七幅原图,补充坐标关系、代价边界和独立数值示例。