杂乱场景 RGB 位姿估计:关键点、PnP 与迭代细化
这篇笔记整理 Yang 等人的论文 6D Object Pose Estimation in Cluttered Scenes from RGB Images(JCST,2022)。方法从一张 RGB 图像估计已知物体的位姿:分割目标,融合外观与几何表示,预测二维关键点候选,再用 EPnP、RANSAC 和渲染反馈细化结果。
理解它需要先分清三件事:运行时只输入 RGB,不等于训练不用深度或三维模型;特征融合不等于直接把特征送进 PnP;细化位姿必须遵守坐标变换的复合规则。
1. 输入、输出与坐标约定
跳转到“1. 输入、输出与坐标约定”设模型点为 ,相机坐标系中的同一点为 。本文统一采用物体到相机的变换:
平移 与模型使用相同长度单位。完整的齐次变换是
常写的 只是 外参块。对去畸变后的针孔图像,有
PnP 的输入是三维模型点、对应的二维像素坐标和相机内参 。颜色、纹理和网络隐特征帮助找到对应关系,但不是可直接代入上述投影方程的三维坐标。
该论文属于已知物体位姿估计。训练阶段可利用数据集中的深度、模型与标注构造监督;推理阶段从 RGB 估计所需表示。不能将“RGB-only”解释成没有几何先验,或把网络预测的几何表示称为传感器实测深度。
2. 整条方法链
跳转到“2. 整条方法链”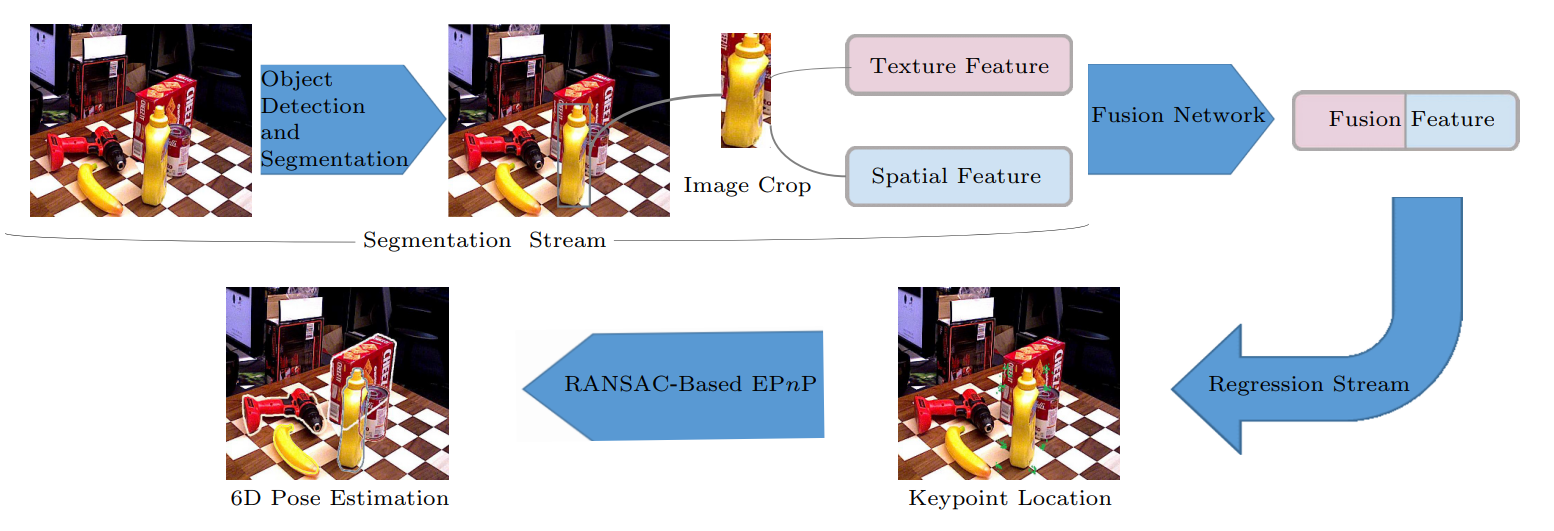
原论文总体流程:分割与回归产生位姿候选,再把当前位姿对应的模型投影用于细化。配图来自原笔记,保留用于对照论文。
- 分割目标区域。 从场景中提取每个目标的区域,降低杂乱背景的干扰。
- 建立融合表示。 颜色分支描述外观,空间表示补充几何约束,二者在对应位置融合。
- 预测关键点候选。 多个网格位置分别预测三维包围盒角点在图像中的位置及置信度。
- 求解位姿。 使用对应点执行 EPnP,并借助 RANSAC 筛除不一致候选。
- 反馈细化。 根据当前位姿渲染或投影已知模型,继续预测修正量。
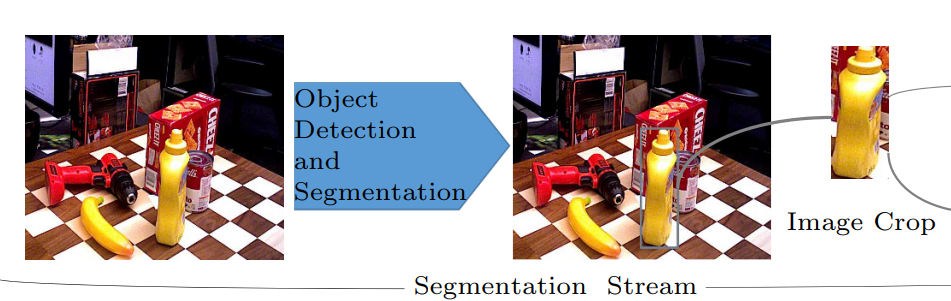
原流程局部图,便于观察分割与回归分支之间的连接。它是整体架构的局部说明,不是另一套独立算法。
裁剪图像后,内参也要变
跳转到“裁剪图像后,内参也要变”假设原图裁剪框左上角为 ,宽高为 ,随后缩放为 。在连续像素坐标约定下:
因此应使用
另一种等价做法是将预测的 变回原图,再使用原始 。图像变成 后继续沿用原内参,会产生系统性位姿误差。若实现采用半像素中心、补边、非零 skew 或畸变模型,必须把实际预处理变换一并纳入;上式只描述明示的连续坐标裁剪与缩放。
3. 特征融合与关键点候选
跳转到“3. 特征融合与关键点候选”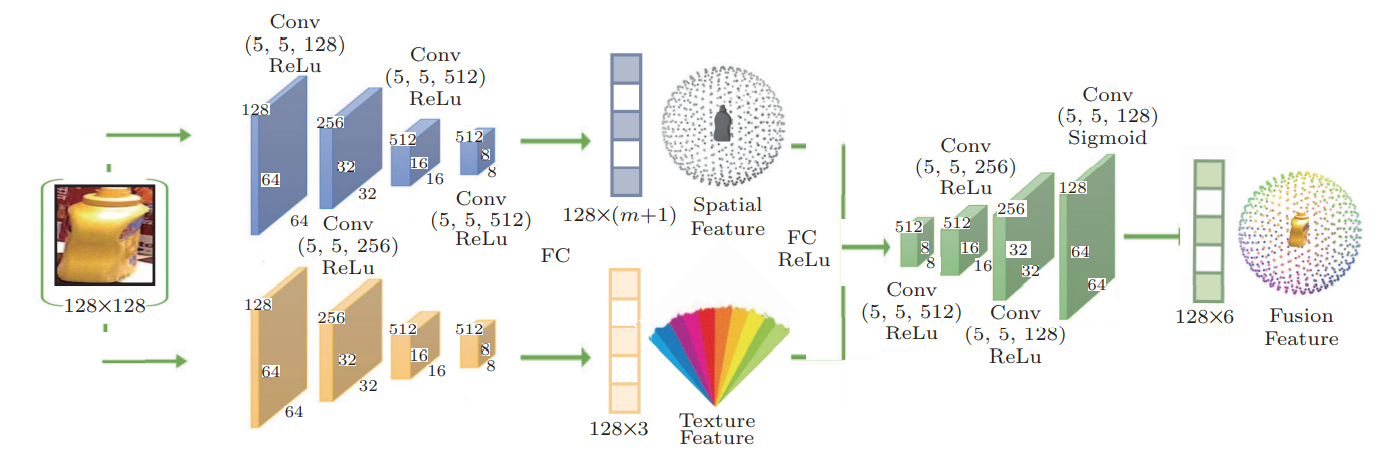
原论文的特征融合结构图。图中的通道数与输入尺寸属于作者的结构设计,几何监督和 RGB 输入应按训练、推理阶段分别理解。
“融合”解决的是表示问题:颜色可以区分纹理或边缘,几何线索可以帮助区分空间布局。两种特征必须对应到同一目标区域;如果图像缩放、掩码或坐标映射不一致,拼接之后的通道也不再描述同一个位置。
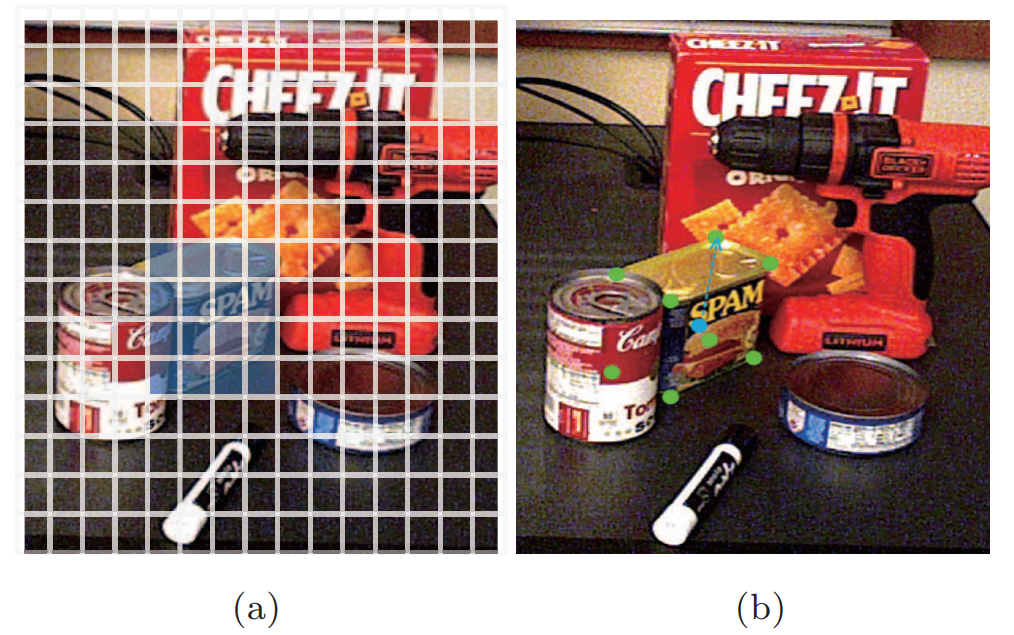
网格预测与三维包围盒角点的二维投影示意。多个网格会给出同一角点的不同候选,后续需要筛选一致的对应关系。
用 表示第 个固定模型角点, 表示网格 对该角点的预测。对应关系是
而不是把所有二维候选随意与三维角点配对。若角点索引错位,即使二维预测很接近物体轮廓,PnP 仍会解出错误姿态。
包围盒角点也不一定在物体表面。它们可能被遮挡,甚至投影到图像外;网络依赖可见区域推断这些位置。RANSAC 能缓解一部分离群点,不能补救所有候选都系统性偏移的情况。
原论文图 6 说明选取置信度最高的 组候选参与 RANSAC 处理。这里的 10 是候选组设置,不是“PnP 至少需要 10 个点”,也不是每个物体只有 10 个三维角点。
4. 损失函数:把论文目标与可实现定义分开
跳转到“4. 损失函数:把论文目标与可实现定义分开”论文同时约束几何位置、纹理信息及置信度。阅读原式时有两处需要保留边界:
- 位置损失的求和与括号排版容易让人误读哪些项参与求和。
- 置信度目标出现 ,但相关文字对位置与纹理量的表示不足以唯一确定维度、归一化和权重。二维位置误差与三通道颜色误差不能直接相加;即使经过编码变成同维向量,也仍需说明尺度。
因此,下列形式用于解释一个维度明确的训练设计,不冒充作者未公开的精确实现。设 为有效预测集合:
表示事先定义好的外观监督量;它可以是颜色或某种描述子,但两侧的语义、维度必须相同。 吸收单位与尺度差异。实现时还应明确如何处理无效像素、遮挡和不同网格中的重复候选。
置信度为何不能全降到零
跳转到“置信度为何不能全降到零”对某个位姿候选,用模型角点的平均变换误差定义标量:
论文采用误差与置信度相乘、再加入对数惩罚的思路。为避免与激活函数重名,这里把惩罚系数记为 :
第一项鼓励高置信度候选具有较小误差,第二项阻止模型把所有 都压到零。对固定 :
它学到的是与误差、系数及单位有关的评分,不自动等于“预测正确的概率”。使用 sigmoid 时 是极限值。对称物体还需要合适的对称性处理,固定角点一一对应的误差并不自动识别等价旋转。更多推导见多尺度位姿估计笔记。
5. 迭代细化:旋转和平移一起复合
跳转到“5. 迭代细化:旋转和平移一起复合”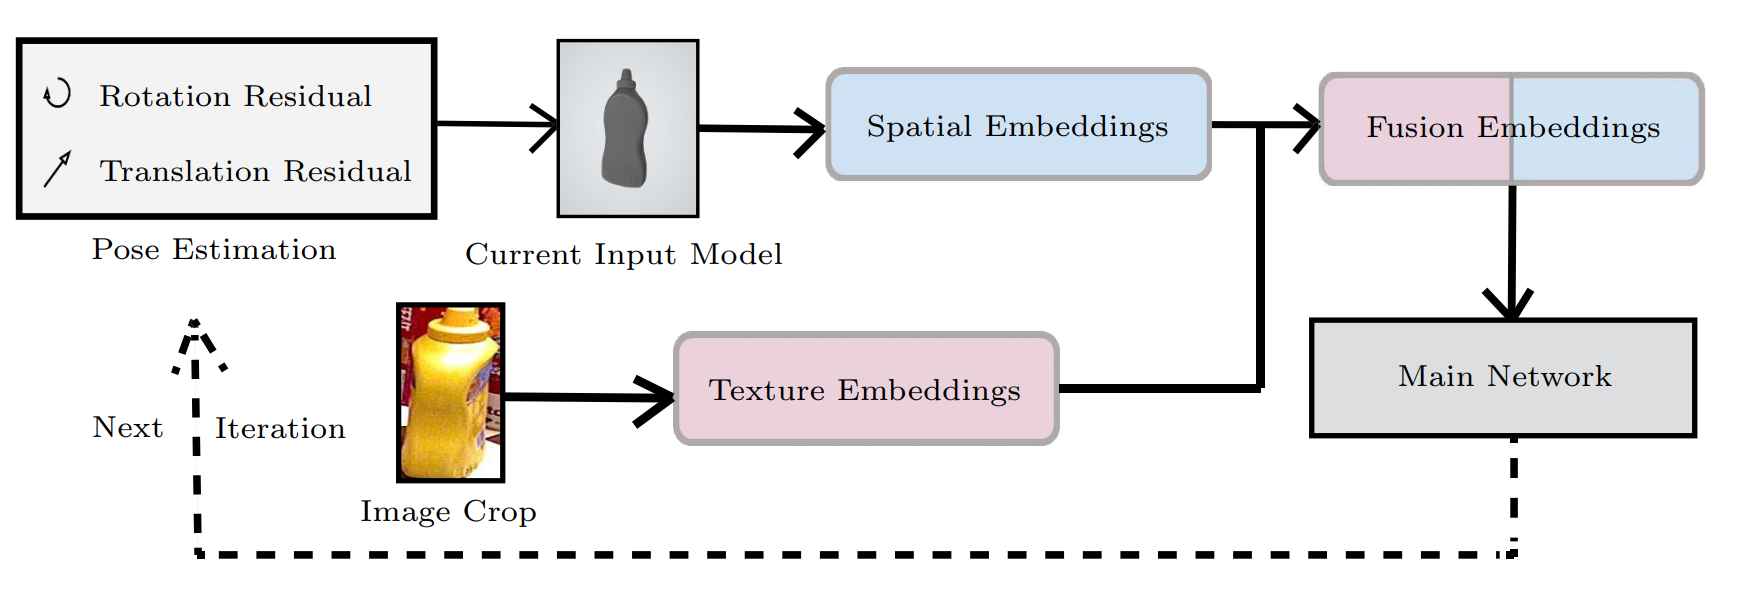
原论文的迭代细化模块。当前估计用于生成模型投影,网络再预测更新量;论文实验设置为两次细化。
若修正量在相机坐标系表达,采用左乘:
展开后得到
所以不能把两个平移直接相加。若修正量在物体局部坐标系表达,则通常是右乘,公式相应变成 。复现时必须先确定输出残差在哪个坐标系。
论文使用的多次左乘可以写成
细化使用当前结果作为起点,并不保证每次都改善:初始对应关系完全错位、模型尺度错误或物体严重遮挡时,都可能落入错误解附近。
6. 一个可运行的几何检查
跳转到“6. 一个可运行的几何检查”下面是独立的 NumPy 教学示例,只验证裁剪投影与左乘细化的代数关系,不运行论文网络。示例中的点位于相机前方,长度单位统一。
import numpy as np
K = np.array([[600., 0., 320.],              [0., 610., 240.],              [0., 0., 1.]])points = np.array([[0.1, 0.2, 2.0],                   [-0.3, 0.1, 1.5],                   [0.4, -0.2, 3.0]])
def project(points_camera, intrinsics):    pixels_h = points_camera @ intrinsics.T    if np.any(points_camera[:, 2] <= 0):        raise ValueError("Points must be in front of the camera")    return pixels_h[:, :2] / pixels_h[:, 2:3]
# Crop (u0, v0, width, height), then resize to 128 x 128.u0, v0, width, height = 100., 60., 400., 300.sx, sy = 128. / width, 128. / heightA = np.array([[sx, 0., -sx * u0],              [0., sy, -sy * v0],              [0., 0., 1.]])uv = project(points, K)uv_crop = (uv - [u0, v0]) * [sx, sy]assert np.allclose(uv_crop, project(points, A @ K))
R_old = np.eye(3)t_old = np.array([1., 0., 2.])R_delta = np.array([[0., -1., 0.],                    [1., 0., 0.],                    [0., 0., 1.]])t_delta = np.array([0.1, 0.2, 0.3])R_new = R_delta @ R_oldt_new = R_delta @ t_old + t_deltax_object = np.array([0.2, 0.1, 0.])x_sequential = R_delta @ (R_old @ x_object + t_old) + t_deltaassert np.allclose(R_new @ x_object + t_new, x_sequential)assert not np.allclose(t_new, t_old + t_delta)print("crop projection and pose composition: OK")
这两个断言很适合放在位姿流水线的入口测试中:它们能定位预处理或坐标约定错误,而这类错误通常无法靠增加训练轮数消除。
7. 如何读实验结果
跳转到“7. 如何读实验结果”原论文在 Occluded-LINEMOD 和 YCB-Video 上比较方法,并通过空间特征、纹理融合及细化的消融分析各部分作用。其 Occluded-LINEMOD 消融表的平均值为:
| 设置 | 论文报告值(%) |
|---|---|
| 仅空间特征 | 35.1 |
| 空间特征与细化 | 36.2 |
| 融合特征 | 40.8 |
| 融合特征与细化 | 42.7 |
表中使用论文所定义的直径相关通过阈值,数据来自原论文表 1,不是本笔记复现实验。融合相对“仅空间特征”提高 5.7 个百分点;不能把这一差值写成普遍的 5.7% 相对提升,也不能由平均值推断每个物体都变好。
“误差低于物体直径的 10%”与“误差低于 10 cm”是不同条件。报告 ADD、ADD-S 或 AUC 时应同时记录使用的对称性约定、阈值、模型单位、数据划分与是否含细化;速度还要记录硬件及是否计入分割和渲染。