RGB-D 位姿估计:注意力、多尺度特征与置信度
这篇笔记整理 Gao 等人的 Efficient 6D object pose estimation based on attentive multi-scale contextual information(IET Computer Vision,2022)。它在 RGB-D 位姿估计中组合两类信息:用注意力调整颜色与几何特征的权重,再用多尺度分支扩大特征覆盖范围,最后为多个位姿候选预测置信度。
阅读重点是每一维张量表示什么、局部邻域如何形成,以及训练误差与推理置信度怎样衔接。本文保留原笔记的全部图像,同时把公式图片转写为可检索的数学表达;原公式图集中保留在文末供核对。
1. 从 RGB-D 到物体位姿
跳转到“1. 从 RGB-D 到物体位姿”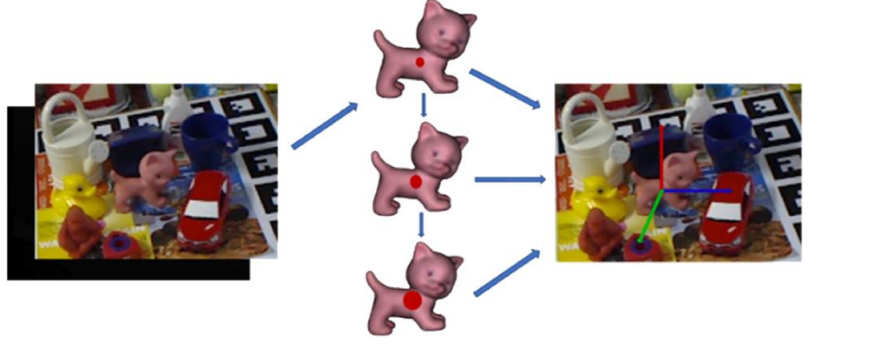
原论文的多尺度多模态特征示意:同一目标的颜色与几何信息在不同尺度上参与位姿预测。
设模型点为 ,目标是在相机坐标系中找到
完整齐次变换为
是外参块,不是完整的 齐次矩阵。深度、模型和 的长度单位必须一致。
对已配准且去畸变的 RGB-D 像素 ,若深度是相机光轴方向的 ,可反投影为
若传感器给的是沿射线距离,需要先转换成光轴深度。RGB 与深度不在同一相机坐标系时,还需外参对齐。注意力模块无法补偿未经标定的错位。
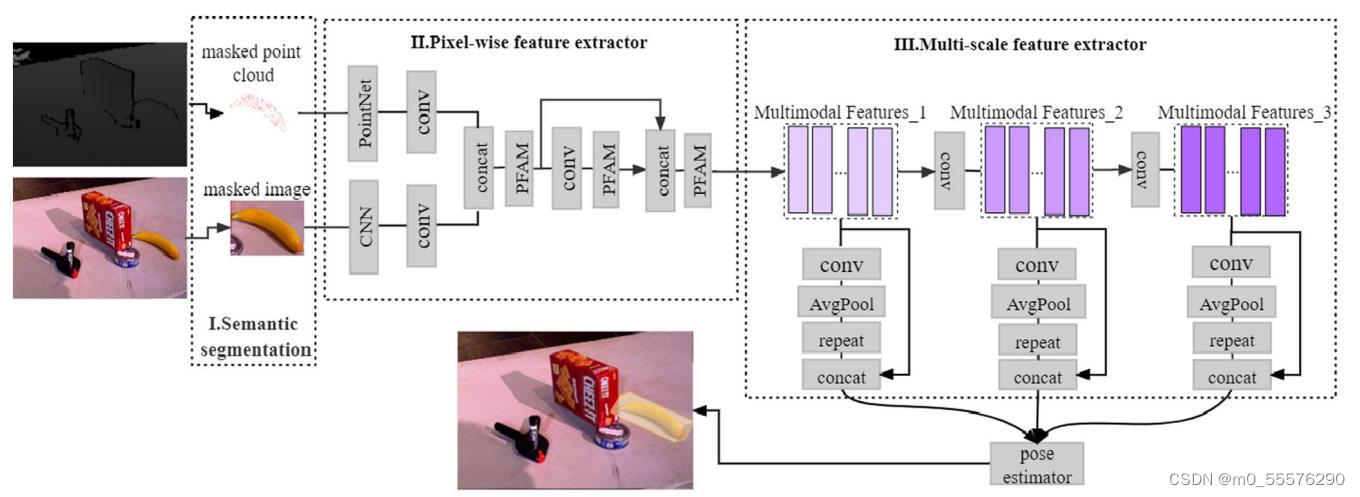
原论文整体结构:目标分割、颜色与点云特征提取、PFAM 注意力、多尺度特征和密集位姿预测。
论文使用已有的目标分割结果,主要研究后续位姿估计。因此评价其“端到端”表述时,应明确是否把分割也纳入共同训练与计时,不能仅凭一张连接完整的结构图作结论。
RGB 方法也可以利用三维模型、相机内参和投影几何,并非完全没有空间信息。RGB-D 的区别是增加了测量深度通道;它也会遇到反光、透明表面、孔洞和边界错配,不能保证所有无纹理目标都能准确估计。
2. 像素与点云特征怎样对应
跳转到“2. 像素与点云特征怎样对应”颜色编码器输出图像特征,点云编码器输出几何特征。融合前需要知道第 个点来自哪个像素,再抽取相应的颜色特征:
这里的分号表示沿通道拼接。同一行必须对应同一采样位置;如果点云随机重排而颜色特征未同步重排,网络看到的是错误配对。
为方便阅读,下文一律把张量写为 : 是点或采样位置数, 是通道数。实际深度学习框架的一维卷积常使用 ,其中 为批量维度,送入层之前需要转置相应轴。
3. PFAM:通道权重与位置权重
跳转到“3. PFAM:通道权重与位置权重”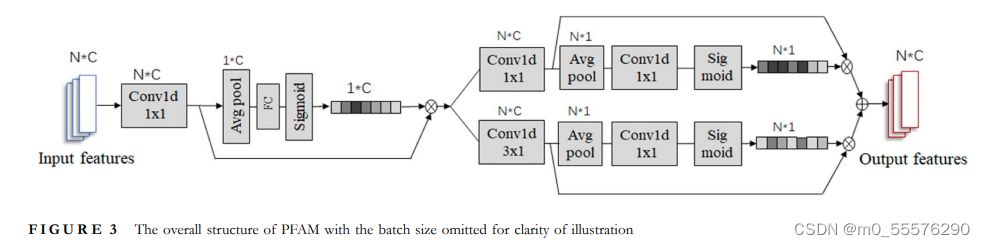
PFAM 结构图。通道注意力之后使用不同卷积核的分支及位置权重,图中还画有旁路连接;精确复现时应同时核对图和正文。
通道注意力
跳转到“通道注意力”设中间特征为 。对位置维求平均,得到每个通道的全局摘要:
的形状是 ,沿 个位置广播:
所以操作是特征乘以注意力图 ,不是把 与自身相乘。 表示中间非线性, 是 sigmoid;这个表达强调广播与权重含义,不补写论文未完整给出的层配置。
不同卷积核与位置权重
跳转到“不同卷积核与位置权重”随后使用核大小为 1 与 3 的一维分支处理特征,并根据分支信息生成位置权重。位置注意力可以用 的权重向量表示,再广播到各通道。通道注意力回答“哪些通道更有用”,位置注意力回答“哪些采样位置更有用”。
论文正文描述两个加权分支相加,结构图还呈现了旁路。若只想理解方法,可把它看作多种上下文范围的加权融合;若要逐层重建,必须落实旁路连接点、padding、激活及归一化,不能把概念公式当作已经验证的官方实现。
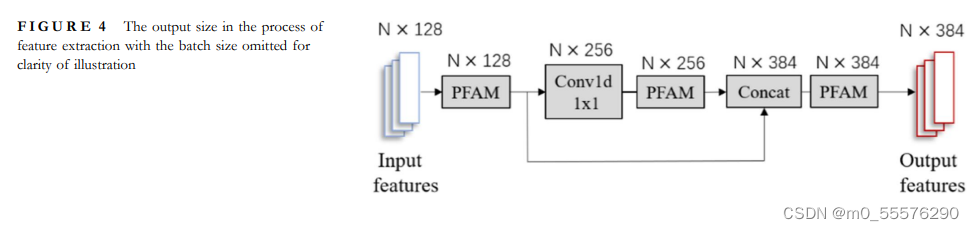
原论文特征尺寸图:两个分支产生 与 特征,拼接为 。
通道拼接得到 ,位置数仍为 。它与按位置堆叠不同;后者会改变采样点数量和对应关系。
4. 多尺度分支:尺寸和感受野分别计算
跳转到“4. 多尺度分支:尺寸和感受野分别计算”设 PFAM 输出 。论文接着使用两个核长为 3、步长为 2 的一维卷积,得到三种尺度:
对于一维卷积,长度为
其中 是 padding, 是 dilation, 是核长, 是步长。以 为例, 时依次得到 500、250、125;奇数长度一般不能直接写成精确的 。
| 尺度 | 位置数( 的示例) | 局部分支通道 | 相对尺度模块输入的感受野 |
|---|---|---|---|
| 1 | 500 | 384 | 1 |
| 2 | 250 | 384 | 3 |
| 3 | 125 | 384 | 7 |
感受野递推应使用
并取 。这里的结果是 ,不是每层简单翻倍。它相对于进入多尺度模块的特征计算;前面的图像编码器和 PFAM 已经包含其他上下文。
还有一个更关键的实现问题:序列相邻不自动等于三维空间相邻。 长度为 3 的 Conv1D 沿采样点序列操作;如果采样点任意打乱,相邻索引可能来自物体相距很远的位置。要将其称为局部空间上下文,必须说明点的排列、像素遍历或邻域构造方式。本文核对的论文不足以唯一恢复这一实现策略,因此不替作者补造。
全局特征必须先广播才能拼接
跳转到“全局特征必须先广播才能拼接”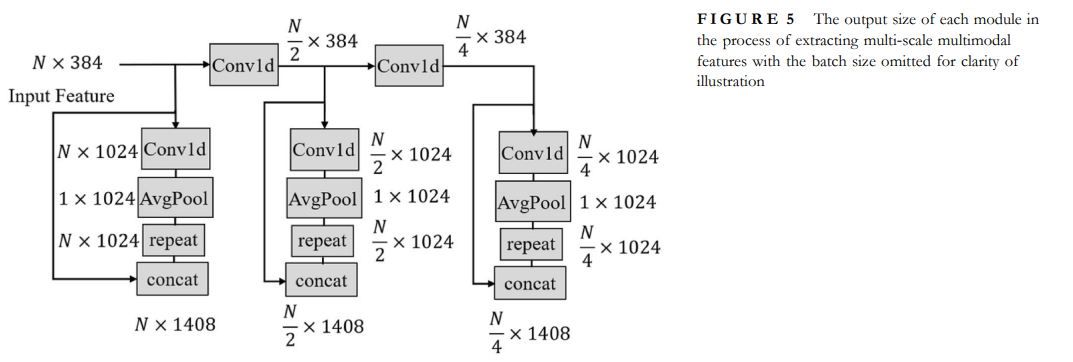
原论文多尺度特征图:每个尺度的局部特征都与该尺度的全局摘要拼接,形成用于位姿预测的特征。
对每个尺度,用映射 将通道变为 1024,再对位置求平均:
然后重复到 行,再沿通道拼接:
。省略 repeat 的紧凑公式只是在默认广播规则,不表示 可以直接和 任意拼接。加入全局分支后,最终特征已包含全体采样位置的信息,不能再把整条输出分支的感受野只写成 3 或 7。
5. 每个候选如何计算位姿误差
跳转到“5. 每个候选如何计算位姿误差”不同尺度和位置产生候选 。设模型采样点为 ,则 ADD 型误差为
这里比较同一个模型点在两种位姿下的位置。对称物体可能存在外观或几何等价的旋转,因此常使用最近点版本:
ADD-S 减弱了一一对应的限制,但不代表对所有对象的可辨识旋转都有完美定义。例如一个纹理可区分、几何近似对称的对象,是否允许等价旋转还与任务有关。
这也解释了为何要区分“关键点刚体拟合”和 ICP:FFB6D 这类方法可以对已知对应的三维关键点做最小二乘配准;ICP 则包含反复更新最近邻对应的过程,二者不是同义词。旧笔记把 PVN3D 的关键点位姿求解写成 ICP,容易误导算法比较。
6. 置信度损失究竟学到了什么
跳转到“6. 置信度损失究竟学到了什么”设候选置信度为 ,所有尺度候选总数为 。用统一索引后的目标写为
这一写法明确按全部候选计数;复现具体实现仍需核对是否对每个尺度单独归一化或加权。训练时 可以由真值计算,推理时通常选择置信度最高的候选:
测试图像没有真值,所以不能在推理时“选择真实误差最小且置信度最高的候选”。
固定误差 ,考察单项
当 :
当 ,损失随 增大而减小,最优值位于 。若用 sigmoid,1 只能作为极限。对数项会惩罚把所有候选置信度压到零的做法,但置信度仍是依赖 和误差尺度的分数,不自动是经过概率校准的正确率。
若长度单位从米改成毫米,误差乘以 1000。为了保持这个单项最优置信度不变, 也需乘以 1000。只改数据单位而保持系数不变,会改变训练目标的相对权重。
可运行的损失与尺寸检查
跳转到“可运行的损失与尺寸检查”下面是独立的 NumPy 教学示例,不包含论文网络或训练权重。
import numpy as np
def optimum_confidence(errors, omega):    e = np.asarray(errors, dtype=float)    if not np.all(np.isfinite(e)) or np.any(e < 0):        raise ValueError("Errors must be finite and nonnegative")    if not np.isfinite(omega) or omega <= 0:        raise ValueError("Omega must be finite and positive")    c = np.ones_like(e)    np.divide(omega, e, out=c, where=e > 0)    return np.minimum(c, 1.0)
errors_m = np.array([0.0, 0.005, 0.03, 0.15])confidence = optimum_confidence(errors_m, 0.015)assert np.allclose(confidence, [1.0, 1.0, 0.5, 0.1])assert np.allclose(    confidence, optimum_confidence(errors_m * 1000, 15.0))
length, receptive_field, jump = 500, 1, 1shapes = [(length, 384, receptive_field)]for _ in range(2):    kernel, stride, padding = 3, 2, 1    length = (length + 2 * padding - (kernel - 1) - 1) // stride + 1    receptive_field += (kernel - 1) * jump    jump *= stride    shapes.append((length, 384, receptive_field))assert shapes == [(500, 384, 1), (250, 384, 3), (125, 384, 7)]assert 384 + 1024 == 1408print("confidence, units and multiscale shapes: OK")
这个函数给出固定误差下的解析最优值,用于理解训练目标。实际网络中的误差和置信度共享参数,不会在每个训练步骤直接运行此函数作为预测器。
7. 论文实验的结论与边界
跳转到“7. 论文实验的结论与边界”原论文第 4.3 节记录了以下训练设置:
| 项目 | 论文记录 |
|---|---|
| 框架与优化器 | PyTorch、Adam |
| 初始学习率 | 0.001 |
| 最大迭代数 | 500(原文为 iterations,未据此换算为 epoch) |
| 批量大小 | 16 |
| 置信度系数 | 0.015 |
| 每个目标的采样位置数 | 500 |
原文 CPU 为 Xeon Gold 5115,但 GPU 型号文字存在歧义,因此这里不据其推定准确的 GPU 配置。上述数值是论文记录,不是本笔记重新训练采用的参数。
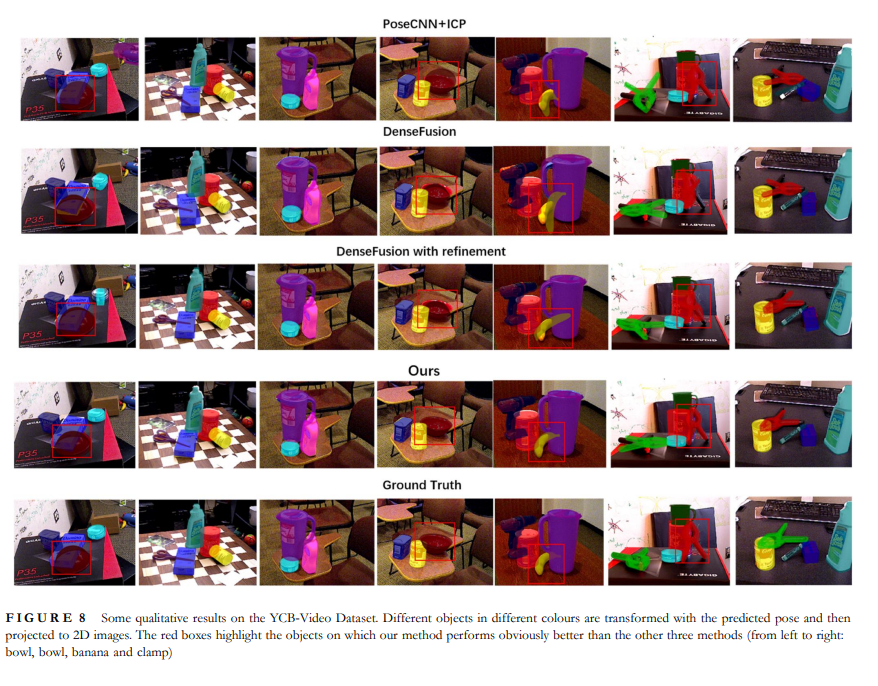
原论文定性结果:多行场景中模型投影与对象位置的对照。此图是预测可视化,不是 ADD 公式的一部分。
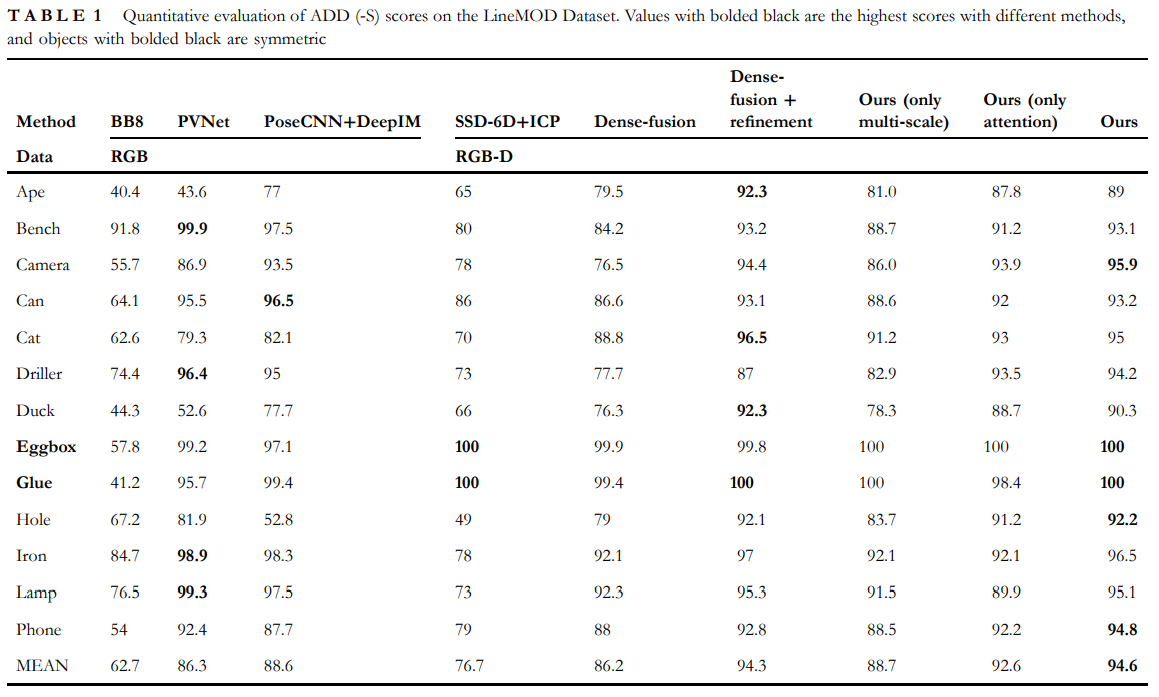
原论文 LineMOD 对比表。数值用于理解作者报告的实验,本文没有重新训练模型。
原表平均值为 94.6,DenseFusion 加细化为 94.3,两者相差 0.3 个百分点。这不是“相对提升 0.3%”,也不意味着每个物体都改善。评价还需要一致的分割输入、模型采样、对称对象设置和阈值。
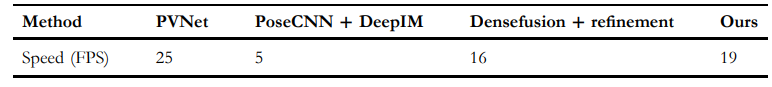
原论文速度对比表:本文方法 19 FPS,对照的 DenseFusion 细化版本 16 FPS。
若仅根据表中数值计算:
前者是吞吐量增加,后者是单帧时间减少,二者不能互换。对应单帧约 52.63 ms 与 62.5 ms。它们属于论文的硬件与计时设置,不是当前电脑测得的速度;若要工程选型,应重新计入数据读取、分割、预处理及多对象推理。
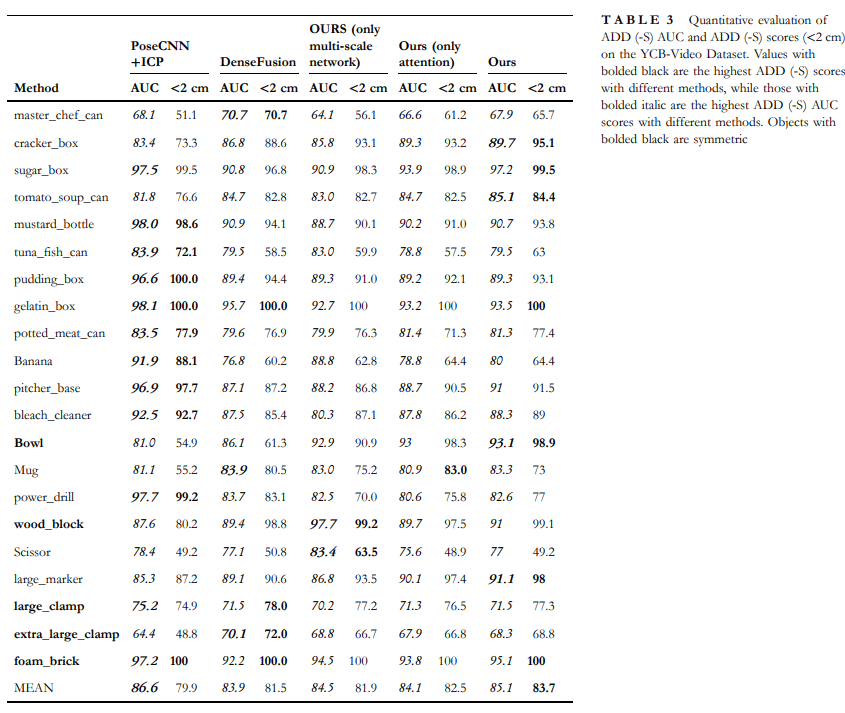
原论文 YCB-Video 结果表,同时列出 AUC 与误差小于 2 cm 的结果。
表中该方法的 AUC 为 85.1,PoseCNN+ICP 为 86.6;误差小于 2 cm 的结果则为 83.7 与 79.9。不同指标给出了不同排序,因此不应改写成所有指标均达到最优。AUC 还必须结合原评测协议中的阈值上限与归一化理解,不能把它当作“小于 2 cm 的比例”。
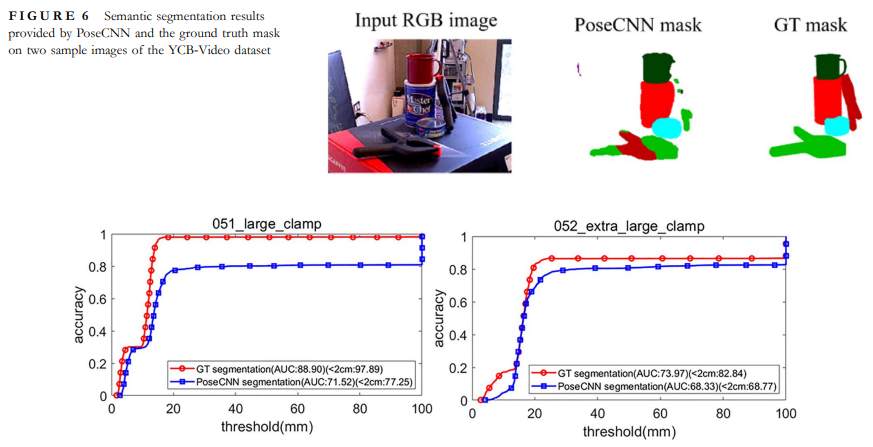
原论文的分割掩码示例及相应性能曲线。该组合图用于讨论分割质量对结果的影响,不是一张 PFAM 模块消融表。
分割错误会改变参与融合的点集合。背景混入会让颜色与几何特征受到污染,目标缺失则会减少可见证据。注意力可以学习抑制部分干扰,但不能保证恢复完全缺失的目标信息。
8. 复现前需要明确的实现细节
跳转到“8. 复现前需要明确的实现细节”目前本文没有确认到能完整对应论文的官方实现。可从结构图理解各模块,但训练复现至少还需固定:
- RGB-D 标定、深度有效范围、单位和点采样方式;
- 点序列如何排列,以及 Conv1D 邻域与空间邻域的关系;
- PFAM 旁路、padding、各分支的归一化与融合位置;
- 每个尺度的候选计数、损失归一化、旋转表示与置信度系数;
- 分割来源、数据划分、对称物体处理和完整推理计时范围。
这篇方法与 FFB6D 的重点不同:前者从密集特征直接产生多个位姿候选,后者预测三维关键点后做几何拟合。与 DGECN 相比,它使用输入的 RGB-D 信息,而不是从单目 RGB 先估计深度。比较实验时应保持输入模态与评价协议一致。
9. 原公式图存档
跳转到“9. 原公式图存档”以下六幅公式图来自原笔记,保留用于追溯。正文已用统一符号重新表达,图中的旧符号不改变本文约定。
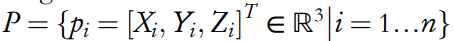
原点云集合公式,对应正文 。

原多尺度特征集合公式,对应三个尺度的 。
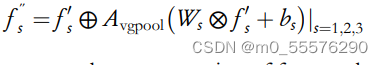
原局部与全局特征融合公式;正文显式写出了全局特征的重复操作。
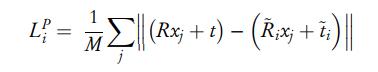
原 ADD 型候选位姿误差公式。
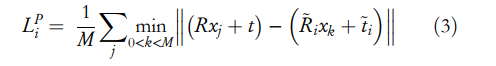
原对称对象最近点误差公式。
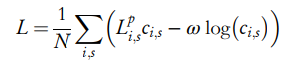
原置信度加权损失公式;正文统一了候选索引与总数定义。