DGECN:单目深度、图卷积与可学习位姿估计
DGECN(CVPR 2022)研究的是:只有 RGB 图像时,能否先估计深度,再利用关键点候选之间的空间关系预测物体位姿? 它把单目深度、二维—三维对应关系和可学习的 DG-PnP 放进同一框架。
这篇笔记同时核对论文与作者公开仓库。两者有重要区别:论文描述完整的深度细化、KFA 融合和 DG-PnP;核对的公开测试入口仍使用 RANSAC/PnP,不能直接视为完整论文的可复现实验。
1. 任务是什么
跳转到“1. 任务是什么”输入是一张 RGB 图像、已知物体的模型与相机标定信息,输出物体坐标系到相机坐标系的变换:
本笔记统一用 表示预测,用 表示真值。原论文在关键点和位姿公式中给星号赋予了不同角色;阅读时不能只根据星号猜测哪一侧是真值。
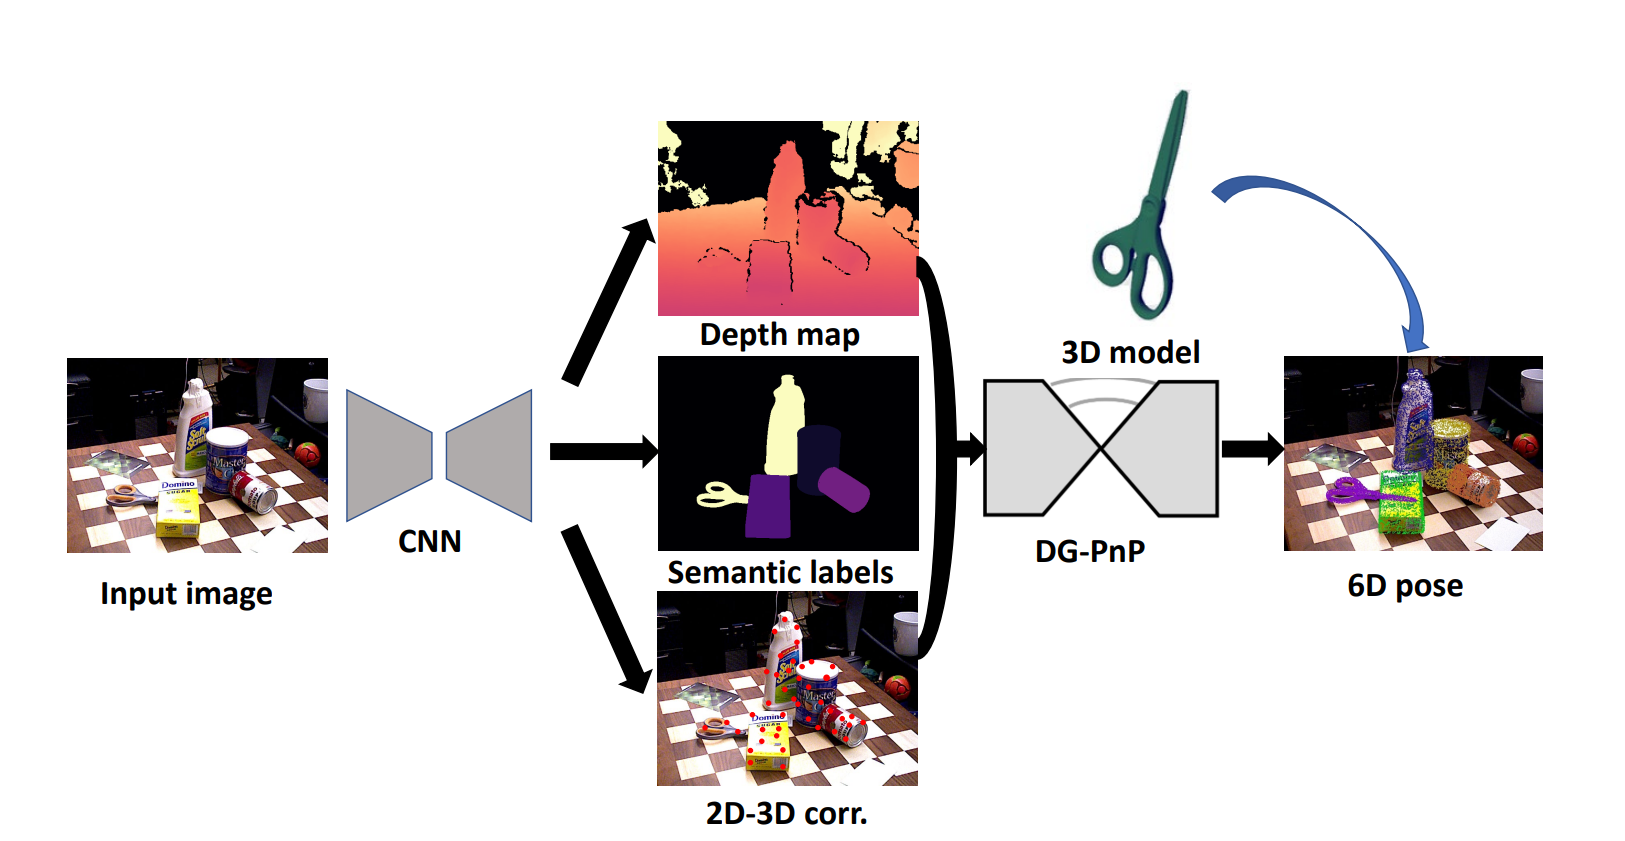
原论文总体流程:RGB 输入产生深度与分割,建立二维—三维对应,再使用 DG-PnP 回归位姿。
传统 PnP 利用
求解几何参数。DG-PnP 则训练一个网络学习候选对应集合到位姿的映射。名称中的 PnP 表示它解决的任务,不表示网络内部必然运行一次传统 PnP 优化。
2. 论文中的三个阶段
跳转到“2. 论文中的三个阶段”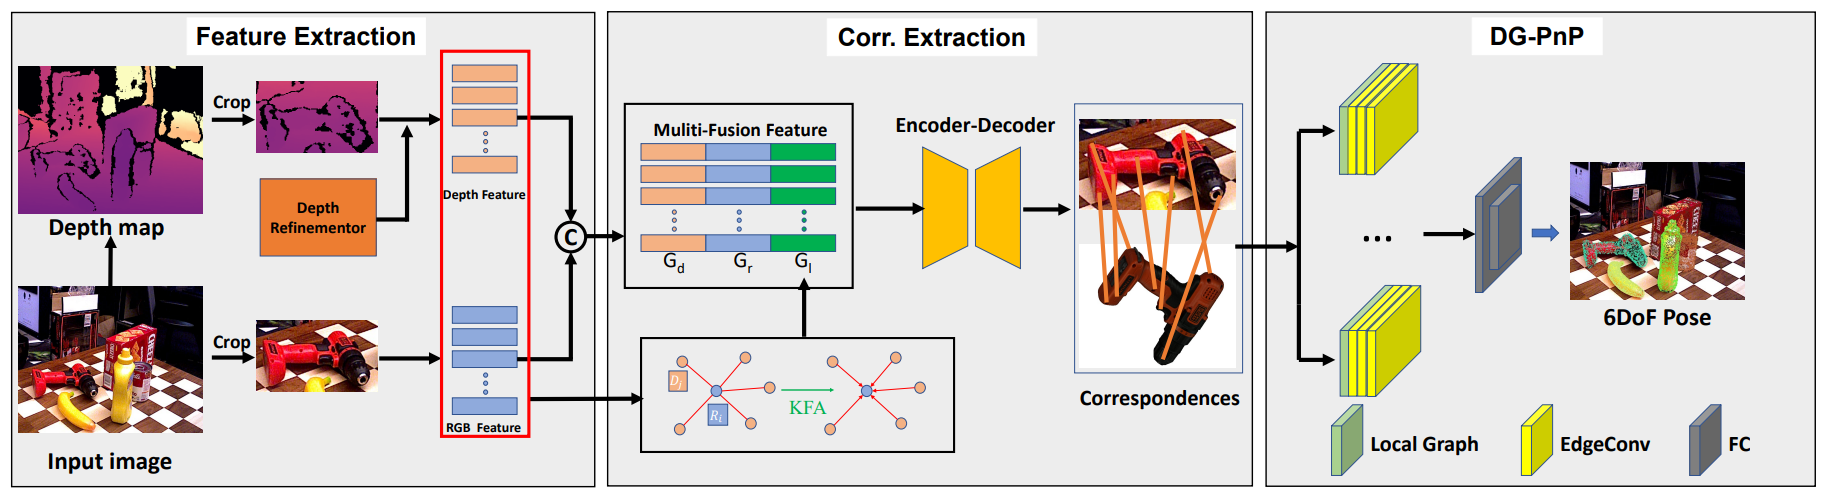
完整架构图:深度与 RGB 特征提取、对应关系提取、DG-PnP。KFA 是近邻特征聚合,DRN 是深度细化网络。
| 阶段 | 核心输入 | 输出及目的 |
|---|---|---|
| 深度与外观提取 | RGB 图像、分割区域 | 单目预测深度、外观特征与局部特征 |
| 对应关系提取 | 融合特征、预定义模型关键点 | 每个三维关键点的多个二维位置候选 |
| DG-PnP | 候选关系及其几何、颜色信息 | 旋转与平移 |
论文中的深度来自网络预测,不是深度相机测量。单目深度常带有尺度或域偏移问题:若使用 反投影, 的尺度会直接影响三维特征。已知物体模型可以提供度量先验,但不能据此认定任意单目深度模型已经输出准确的米制深度。
3. 两张深度图的分歧能告诉我们什么
跳转到“3. 两张深度图的分歧能告诉我们什么”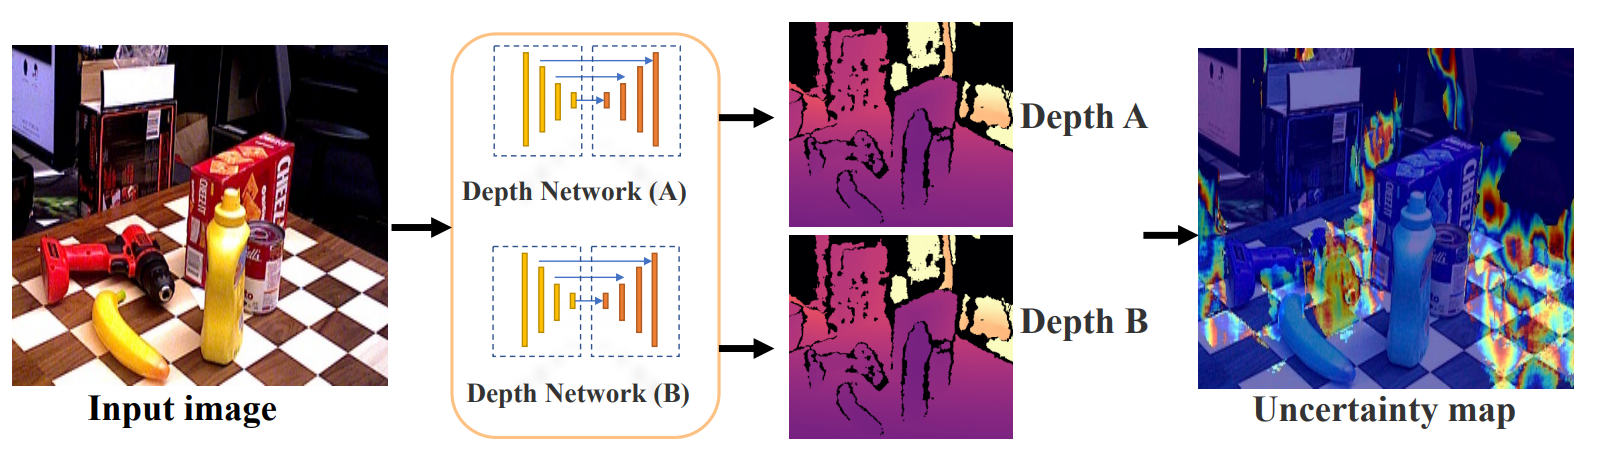
原论文的深度分歧示意:两套深度网络分别产生预测,再利用差异标记不稳定区域。
设两套深度预测为 。论文用两者的差异与阈值识别不确定区域,并在其方案中移除这些区域的深度特征。一个便于说明的掩码是
真实实现还应排除 NaN、无穷值,并明确“移除”是删除点、设置掩码还是屏蔽特征;这些做法不完全等价。直接填零可能让网络把无效深度误认为靠近相机的有效表面。
差异阈值有两个前提:
- 两张深度图已对齐到同一像素网格,具有可比较的尺度与单位。
- 分歧只是启发式不稳定信号,不是经过校准的概率不确定性。
两个网络可能同时把一个 1 m 的点预测成 2 m,差异依然为零。相反,两套相对深度预测若只差全局尺度,也可能到处触发掩码。这些情形必须通过尺度校正或独立标注检查,而不能靠降低阈值解决。
下面的独立 NumPy 示例只检查有效值与分歧掩码:
import numpy as np
def agreement_mask(depth_a, depth_b, threshold):    a = np.asarray(depth_a, dtype=float)    b = np.asarray(depth_b, dtype=float)    if a.shape != b.shape or a.ndim != 2:        raise ValueError("Depth maps must have the same 2-D shape")    if not np.isfinite(threshold) or threshold < 0:        raise ValueError("Threshold must be finite and nonnegative")    valid = np.isfinite(a) & np.isfinite(b) & (a > 0) & (b > 0)    mask = np.zeros(a.shape, dtype=bool)    mask[valid] = np.abs(a[valid] - b[valid]) <= threshold    return mask
a = [[1.0, 2.0, np.nan], [0.0, 1.0, 2.0]]b = [[1.01, 2.0, 1.0], [1.0, 1.5, 2.0]]mask = agreement_mask(a, b, 0.05)assert np.array_equal(mask, [[True, True, False],                             [False, False, True]])
# Agreement does not prove accuracy: both predict 2 m for a 1 m point.assert agreement_mask([[2.0]], [[2.0]], 0.05).item()assert abs(2.0 - 1.0) == 1.0print("depth agreement mask: OK")
4. KFA 与关键点候选
跳转到“4. KFA 与关键点候选”对像素 ,KFA 将其近邻深度信息送入可学习函数,得到局部特征;再与 RGB 特征和深度特征融合。论文使用 K-NN 描述邻域,但核对的公开仓库未提供完整 KFA,因此不能凭结构图补出唯一的距离度量、归一化方法和全部张量尺寸。
“最近”必须说明在哪个空间:图像坐标、反投影三维坐标和学习特征空间,得到的邻域通常不同。将毫米制 XYZ 与 的 RGB 直接计算欧氏距离,也会使几何通道占据几乎全部权重。
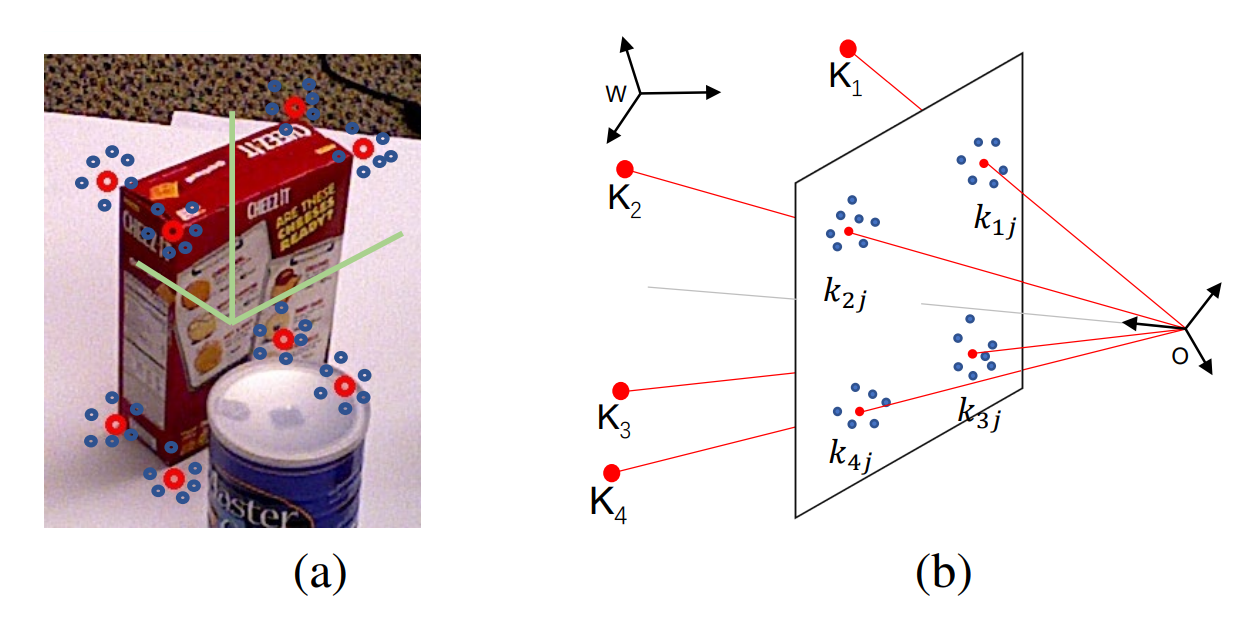
模型关键点的真实二维投影与多组预测候选。图中的红点和蓝色候选簇用于说明同一关键点的多解预测。
论文采用最远点采样(FPS)选择模型表面关键点。相比虚拟包围盒角点,它们贴近真实几何表面,但 FPS 不保证关键点在当前视角可见,也不保证其投影位于图像内。遮挡、截断和背面点依然存在。
设模型关键点为 ,第 个关键点的候选像素为 。关键点索引 必须贯穿模型与预测分支;把候选作为点集处理,不意味着可以丢失对应的三维关键点身份。
5. EdgeConv 如何利用邻域
跳转到“5. EdgeConv 如何利用邻域”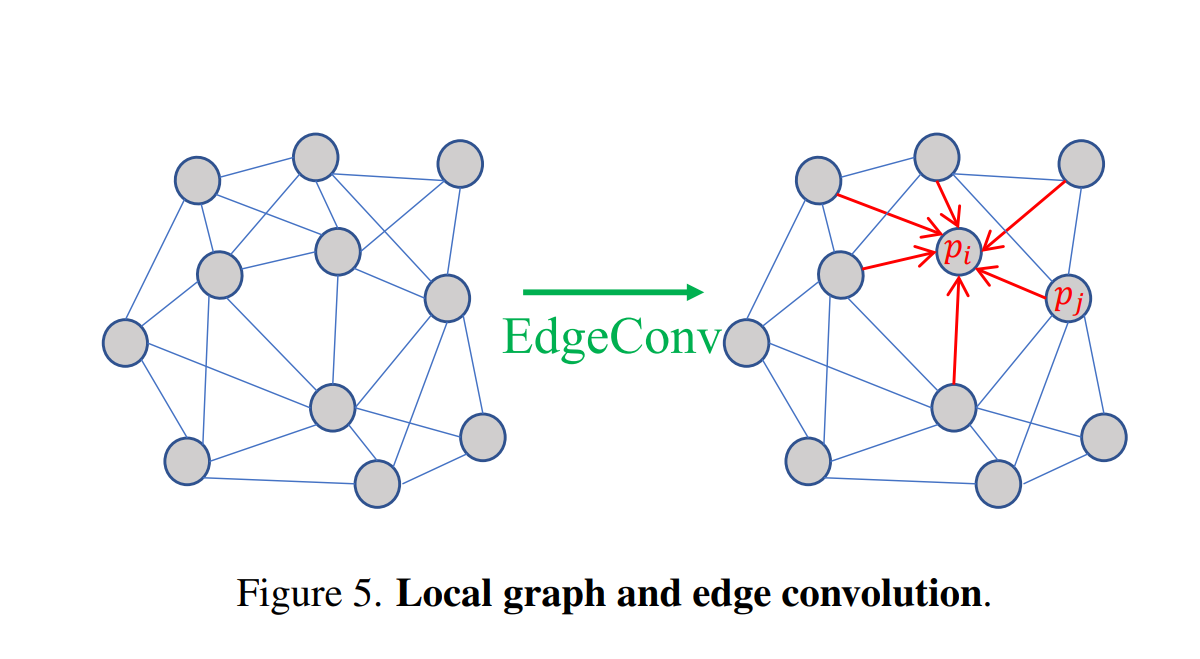
局部图与边卷积示意。每个节点与选定邻居相连,再聚合边特征。
图网络的价值在于显式选择邻接关系。它与普通网格卷积的差异主要在邻域组织和共享算子的使用方式,不能简单归结为“CNN 处理有序数据、GCN 处理无序数据”。
为了说明形状,设节点特征 ,共享矩阵 。一种教学用边函数为
这里 AGG 可以是最大值或加权求和,但两者是不同算子。共享矩阵与对称聚合有利于使输出随节点置换等变;全局对称池化进一步得到与输入顺序无关的表示。K-NN 距离完全相同时,邻居选择的打破平局规则也可能影响这一性质。
上式是形状明确的讲解形式。论文公式使用相反的差分符号、距离相关权重与求和;公开 DG-PnP 代码使用邻居减中心、特征拼接及最大池化。差分符号可由可学习权重吸收,但聚合方式及输入维度的差异不能忽略。
若只有相对差分,平移后的坐标差不变;加入中心绝对坐标项后,不能再声称整个网络具有平移不变性。旋转不变性同样不会因为“使用了图”自动成立。位姿任务本来就需要保留适当的相机坐标信息,关键是明确希望网络满足什么性质。
6. 多任务训练与评价指标
跳转到“6. 多任务训练与评价指标”论文总目标包含深度、分割、关键点和位姿四项:
深度目标借鉴 MonoDepth2 的光度重投影和平滑项。自监督深度训练通常依赖相邻视图及可重投影关系;“推理只需要单张图像”不能推成“训练时只用一张 RGB 就能获得全部几何监督”。
把关键点损失写成统一记号:
这里假设每个关键点有 个有效候选;若候选数或可见性不同,应改用有效项的实际计数。位姿损失则比较模型点变换之后的距离:
这一形式与 ADD 相同。对称物体常采用最近点版本:
最近点可减轻对称姿态的惩罚,但它不等价于完整的物体对称群定义,也可能在某些形状上低估错误。
| 指标或阈值 | 含义 | 单位 |
|---|---|---|
| ADD、ADD-S | 三维模型变换后的平均距离 | 与模型相同 |
| 通过率 | 距离小于物体直径的 10% 的样本比例 | % |
| REP-5px | 平均重投影误差小于 5 像素的比例 | % |
| ADD-S AUC | 扫描距离阈值得到曲线下面积 | 依评价归一化约定 |
DGECN 的 YCB-V AUC 使用最高 10 cm 的距离阈值。10 cm 与 不能互换,大物体和小物体受到的约束不同。
7. 实验应怎样解释
跳转到“7. 实验应怎样解释”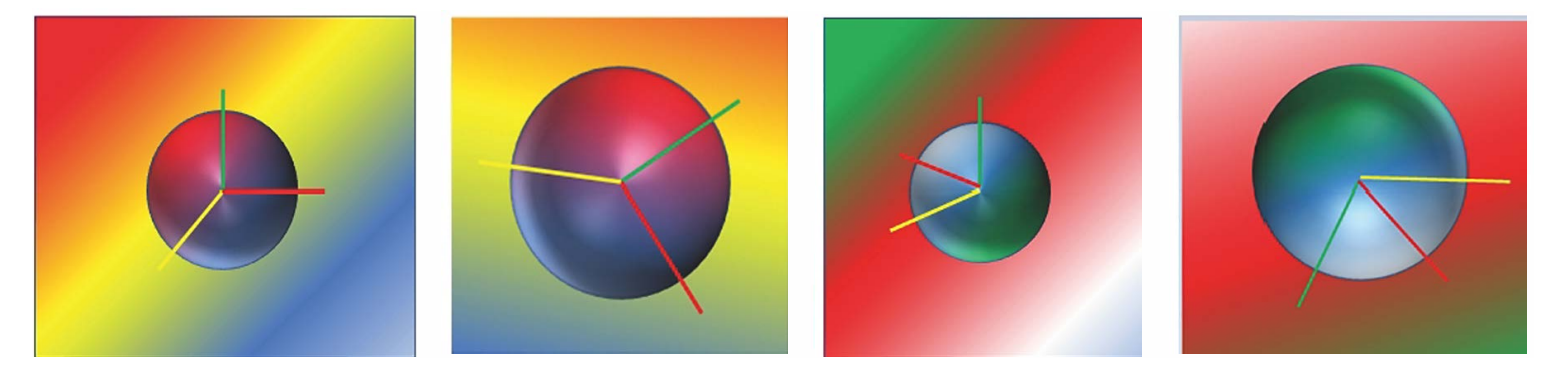
原论文的合成球体数据示意。已知对应关系有助于单独考察位姿求解模块,但不能代表真实图像中关键点检测和分割的全部误差。
论文在合成对应关系中加入噪声与离群点,再比较多种 PnP 方法。该实验隔离了对应提取器的影响;它能说明特定噪声设置下的鲁棒性,不能证明学习式求解器在所有相机、对象和噪声分布下都更好。
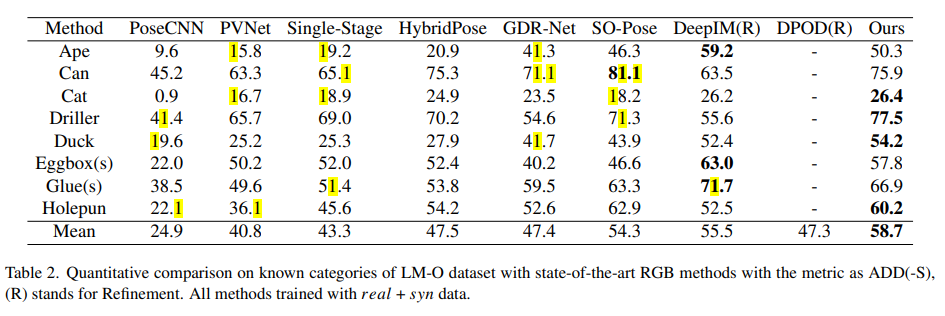
原论文表 2:LM-O 上与其他 RGB 方法的比较。旧笔记误配成“表 1 消融研究”,此处按图中实际内容更正。
这里列出的 LM-O 评测涉及 8 个对象。原论文数据介绍中的“13 个视频、13 个物体”容易与常用 LINEMOD 子集混淆;不要把该描述当作本表对象数量。LM-O 来源于 LM 场景的额外遮挡对象标注,可对照 BOP 数据集说明。
原笔记中的 YCB-V 表格保留如下,数值均为论文报告:
| 方法 | 使用细化 | ADD(-S) | REP-5px | ADD-S AUC |
|---|---|---|---|---|
| PoseCNN | — | 21.3 | 3.7 | 75.9 |
| GDR-Net | — | 60.1 | — | 91.6 |
| SO-Pose | — | 56.8 | — | 90.9 |
| PVNet | — | — | 47.4 | 73.4 |
| SegDriven | — | 39.0 | 30.8 | — |
| Single-Stage | — | 53.9 | 48.7 | — |
| DeepIM | 是 | — | — | 88.1 |
| CosyPose | 是 | — | — | 89.8 |
| DGECN | — | 60.6 | 50.3 | 90.9 |
“—”对应原表空白或未提供值,不表示零。DGECN 的部分列更高,但 AUC 低于 GDR-Net 的 91.6,不能概括成所有指标第一。
原论文表 4 的深度消融也保留:
| 对应提取器使用深度 | DG-PnP 使用深度 | ADD | ADD-S AUC |
|---|---|---|---|
| 是 | 是 | 58.7 | 90.9 |
| 是 | 否 | 53.2 | 83.5 |
| 否 | 是 | 50.6 | 81.3 |
| 否 | 否 | 41.3 | 75.3 |
表 4 的标题没有充分交代每列数据集与聚合协议;其 58.7 又与 LM-O 主表均值一致,而 90.9 与 YCB-V AUC 一致。因此这些数字保留为原表记录,不擅自补成“同一数据集上的两项指标”,也不计算跨列综合提升。
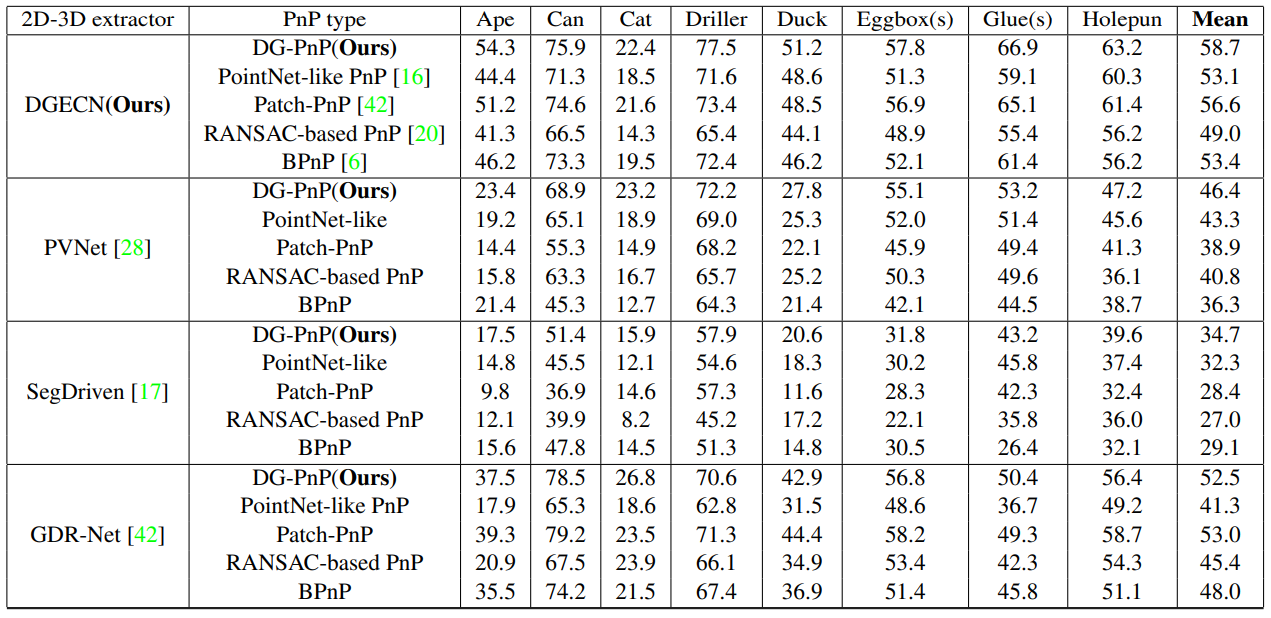
原论文表 1:替换对应提取器和 PnP 模块的组合消融。它与前面的表 2 是两张不同的表,逐对象数值不能互相代替。
组合消融也展示了边界:GDR-Net 配 DG-PnP 的均值为 52.5,配 Patch-PnP 为 53.0。更换求解器的收益取决于前端对应关系的分布;不能把“图网络”视为对所有前端都有效的替换件。
8. 公开实现实际提供了什么
跳转到“8. 公开实现实际提供了什么”以下核对固定在作者仓库提交 f05e583cc3b3e8154b089f47ceb1b94bf8f370e3,属于源码检查,未运行预训练推理。
| 核对位置 | 可确认的行为 | 复现意义 |
|---|---|---|
| README | 说明测试代码不包含 KFA、DRN;另外提供 DG-PnP | 不能把此入口当作完整训练方案 |
test.py → utils.do_detect_all → fusion | 最终调用 cv2.solvePnPRansac,使用 EPnP 标志 | 发布测试流程仍是传统几何求解 |
dgecn.py | 深度分支与主干的连接是将预测深度加到输入上 | 不等同于论文图中的完整多特征 KFA 融合 |
corr_extractor/DG_PnP.py | K-NN、邻居减中心并拼接中心、最大聚合、全局最大与平均池化 | 与论文的距离加权求和描述有差别 |
| DG-PnP 第一层 | 边特征输入通道为 6,按其拼接逻辑对应原始 3 通道输入 | 不能直接按论文“XYZ+RGB 六维节点”输入而不改结构 |
此外,该 DG-PnP 文件内部创建索引时固定使用 CUDA,输出为 7 个原始数值;这个单独文件不足以确定完整位姿参数的解码、旋转归一化和训练流程。代码注释中的部分通道数字也与实际层定义不一致,应以层定义及张量形状为准。
README 说明提供的预训练模型只使用视频 0000–0010 训练,并未覆盖完整基准训练集。公开测试结果、单独模块实验和论文完整结果应分开记录。本笔记不把静态代码检查写成神经网络精度或速度复现。
9. 阅读与复现顺序
跳转到“9. 阅读与复现顺序”先验证图像、深度和内参的对齐,再验证模型单位和对应索引。随后分别运行关键点评价、几何 PnP 基线与学习式求解器,记录相同候选上的差异。只有输入协议和训练数据一致,才适合讨论网络结构本身的收益。
- 原论文:Cao 等,DGECN: A Depth-Guided Edge Convolutional Network for End-to-End 6D Pose Estimation,CVPR 2022。
- 作者仓库固定版本:可直接查阅 README、测试链和独立 DG-PnP 文件。
- RGB 位姿估计与裁剪内参、FFB6D 的三维关键点拟合:分别对应二维投影几何与三维刚体配准。
- CSDN 原笔记:首次发布于 2022-10-28。本文保留全部八幅原图及两张原数据表,重新组织解释与实现核对。